数据导入与解析
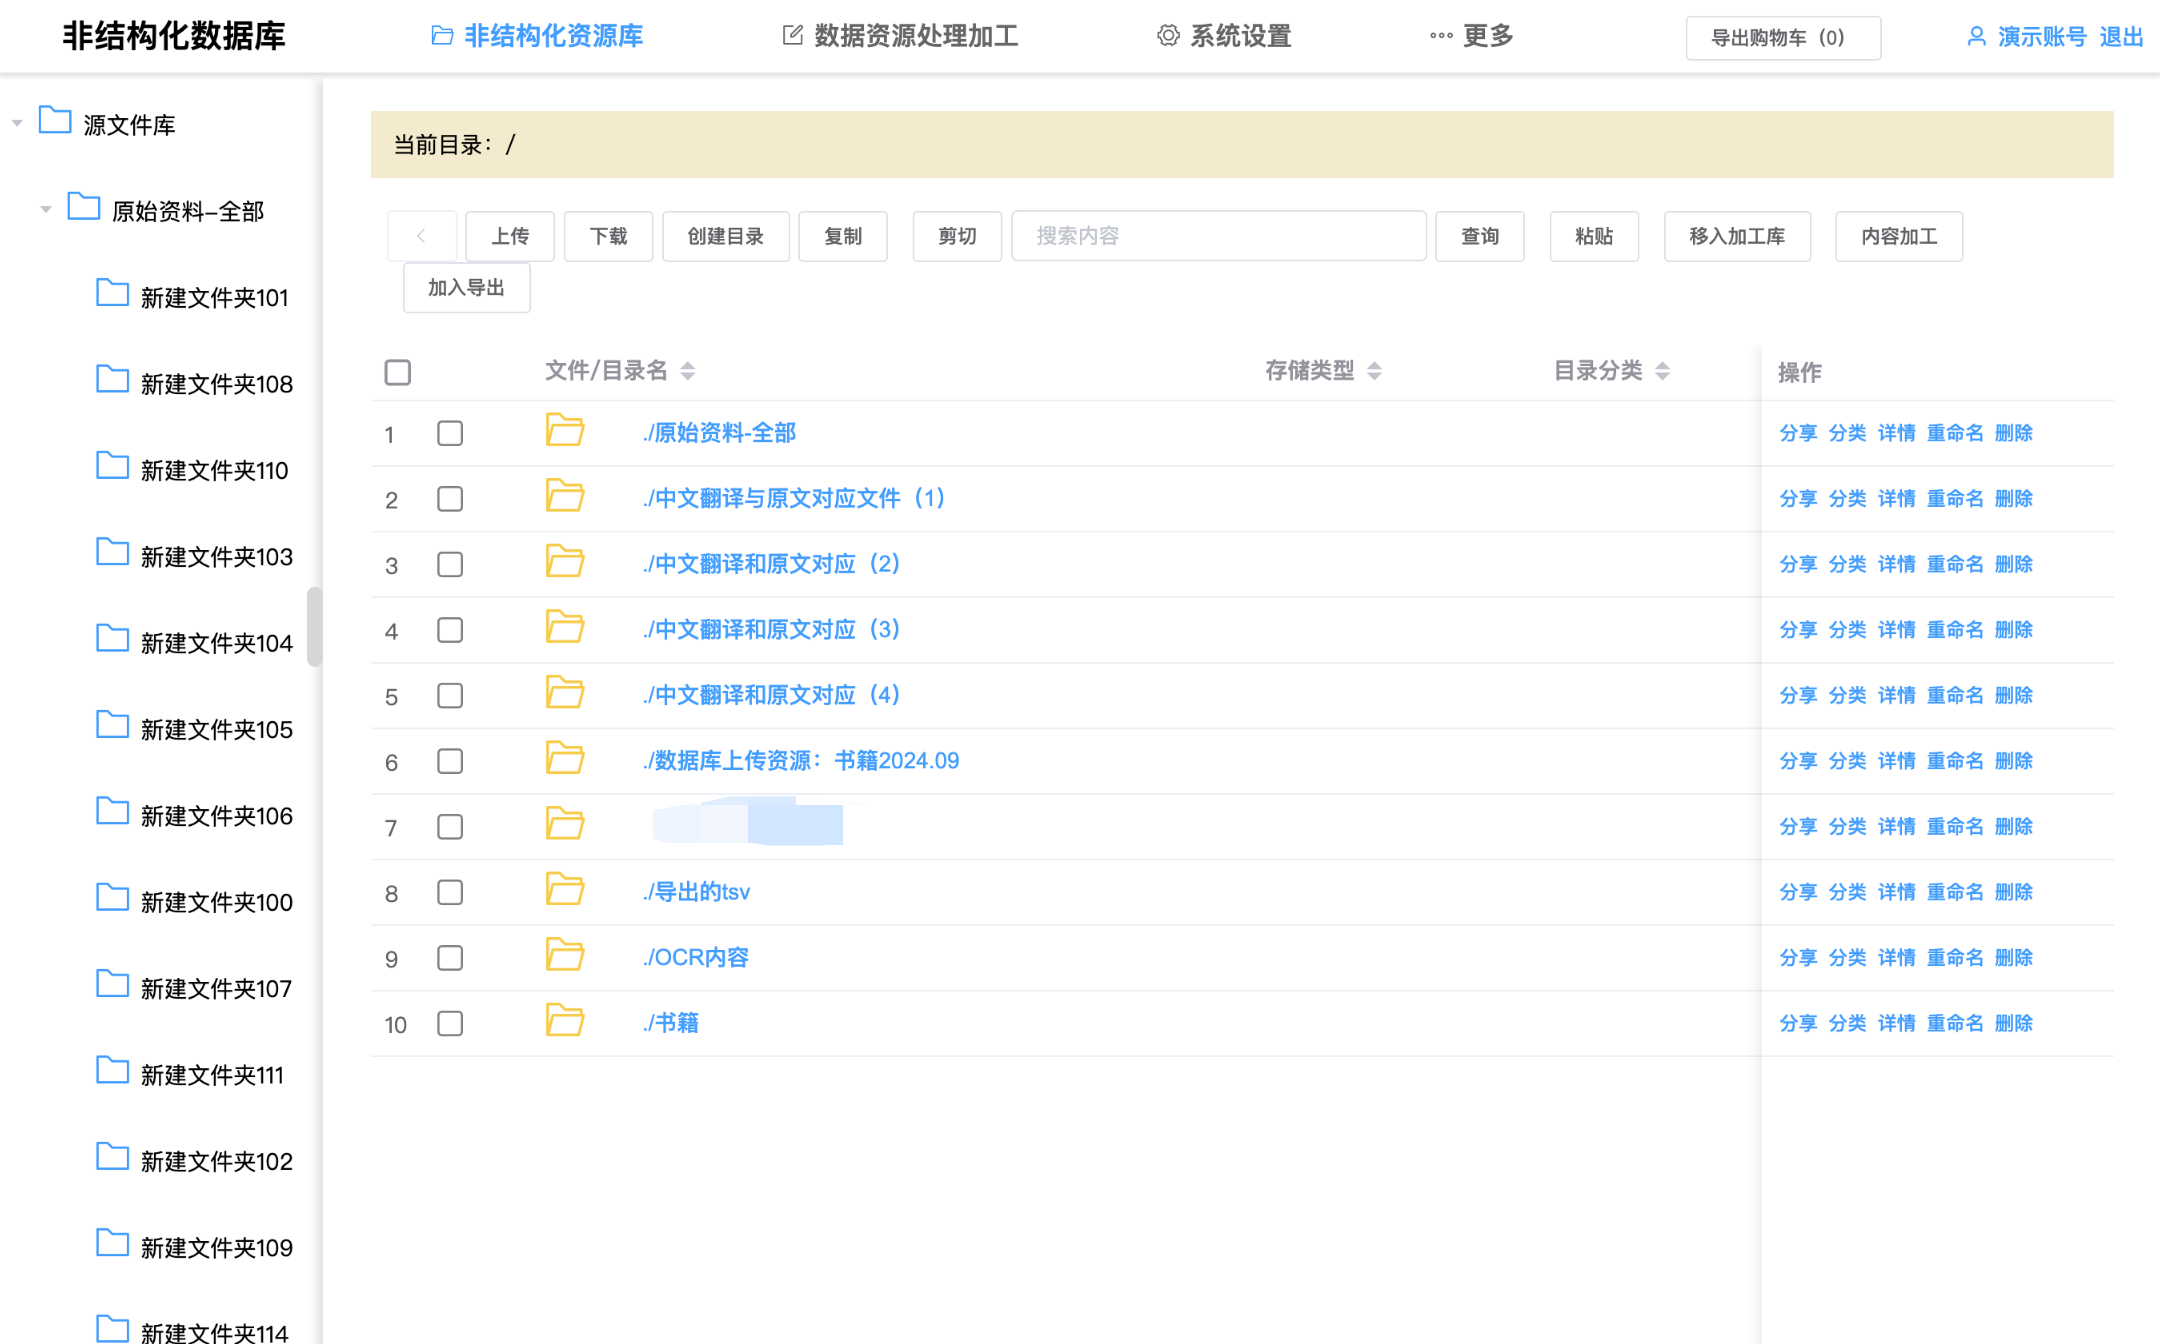
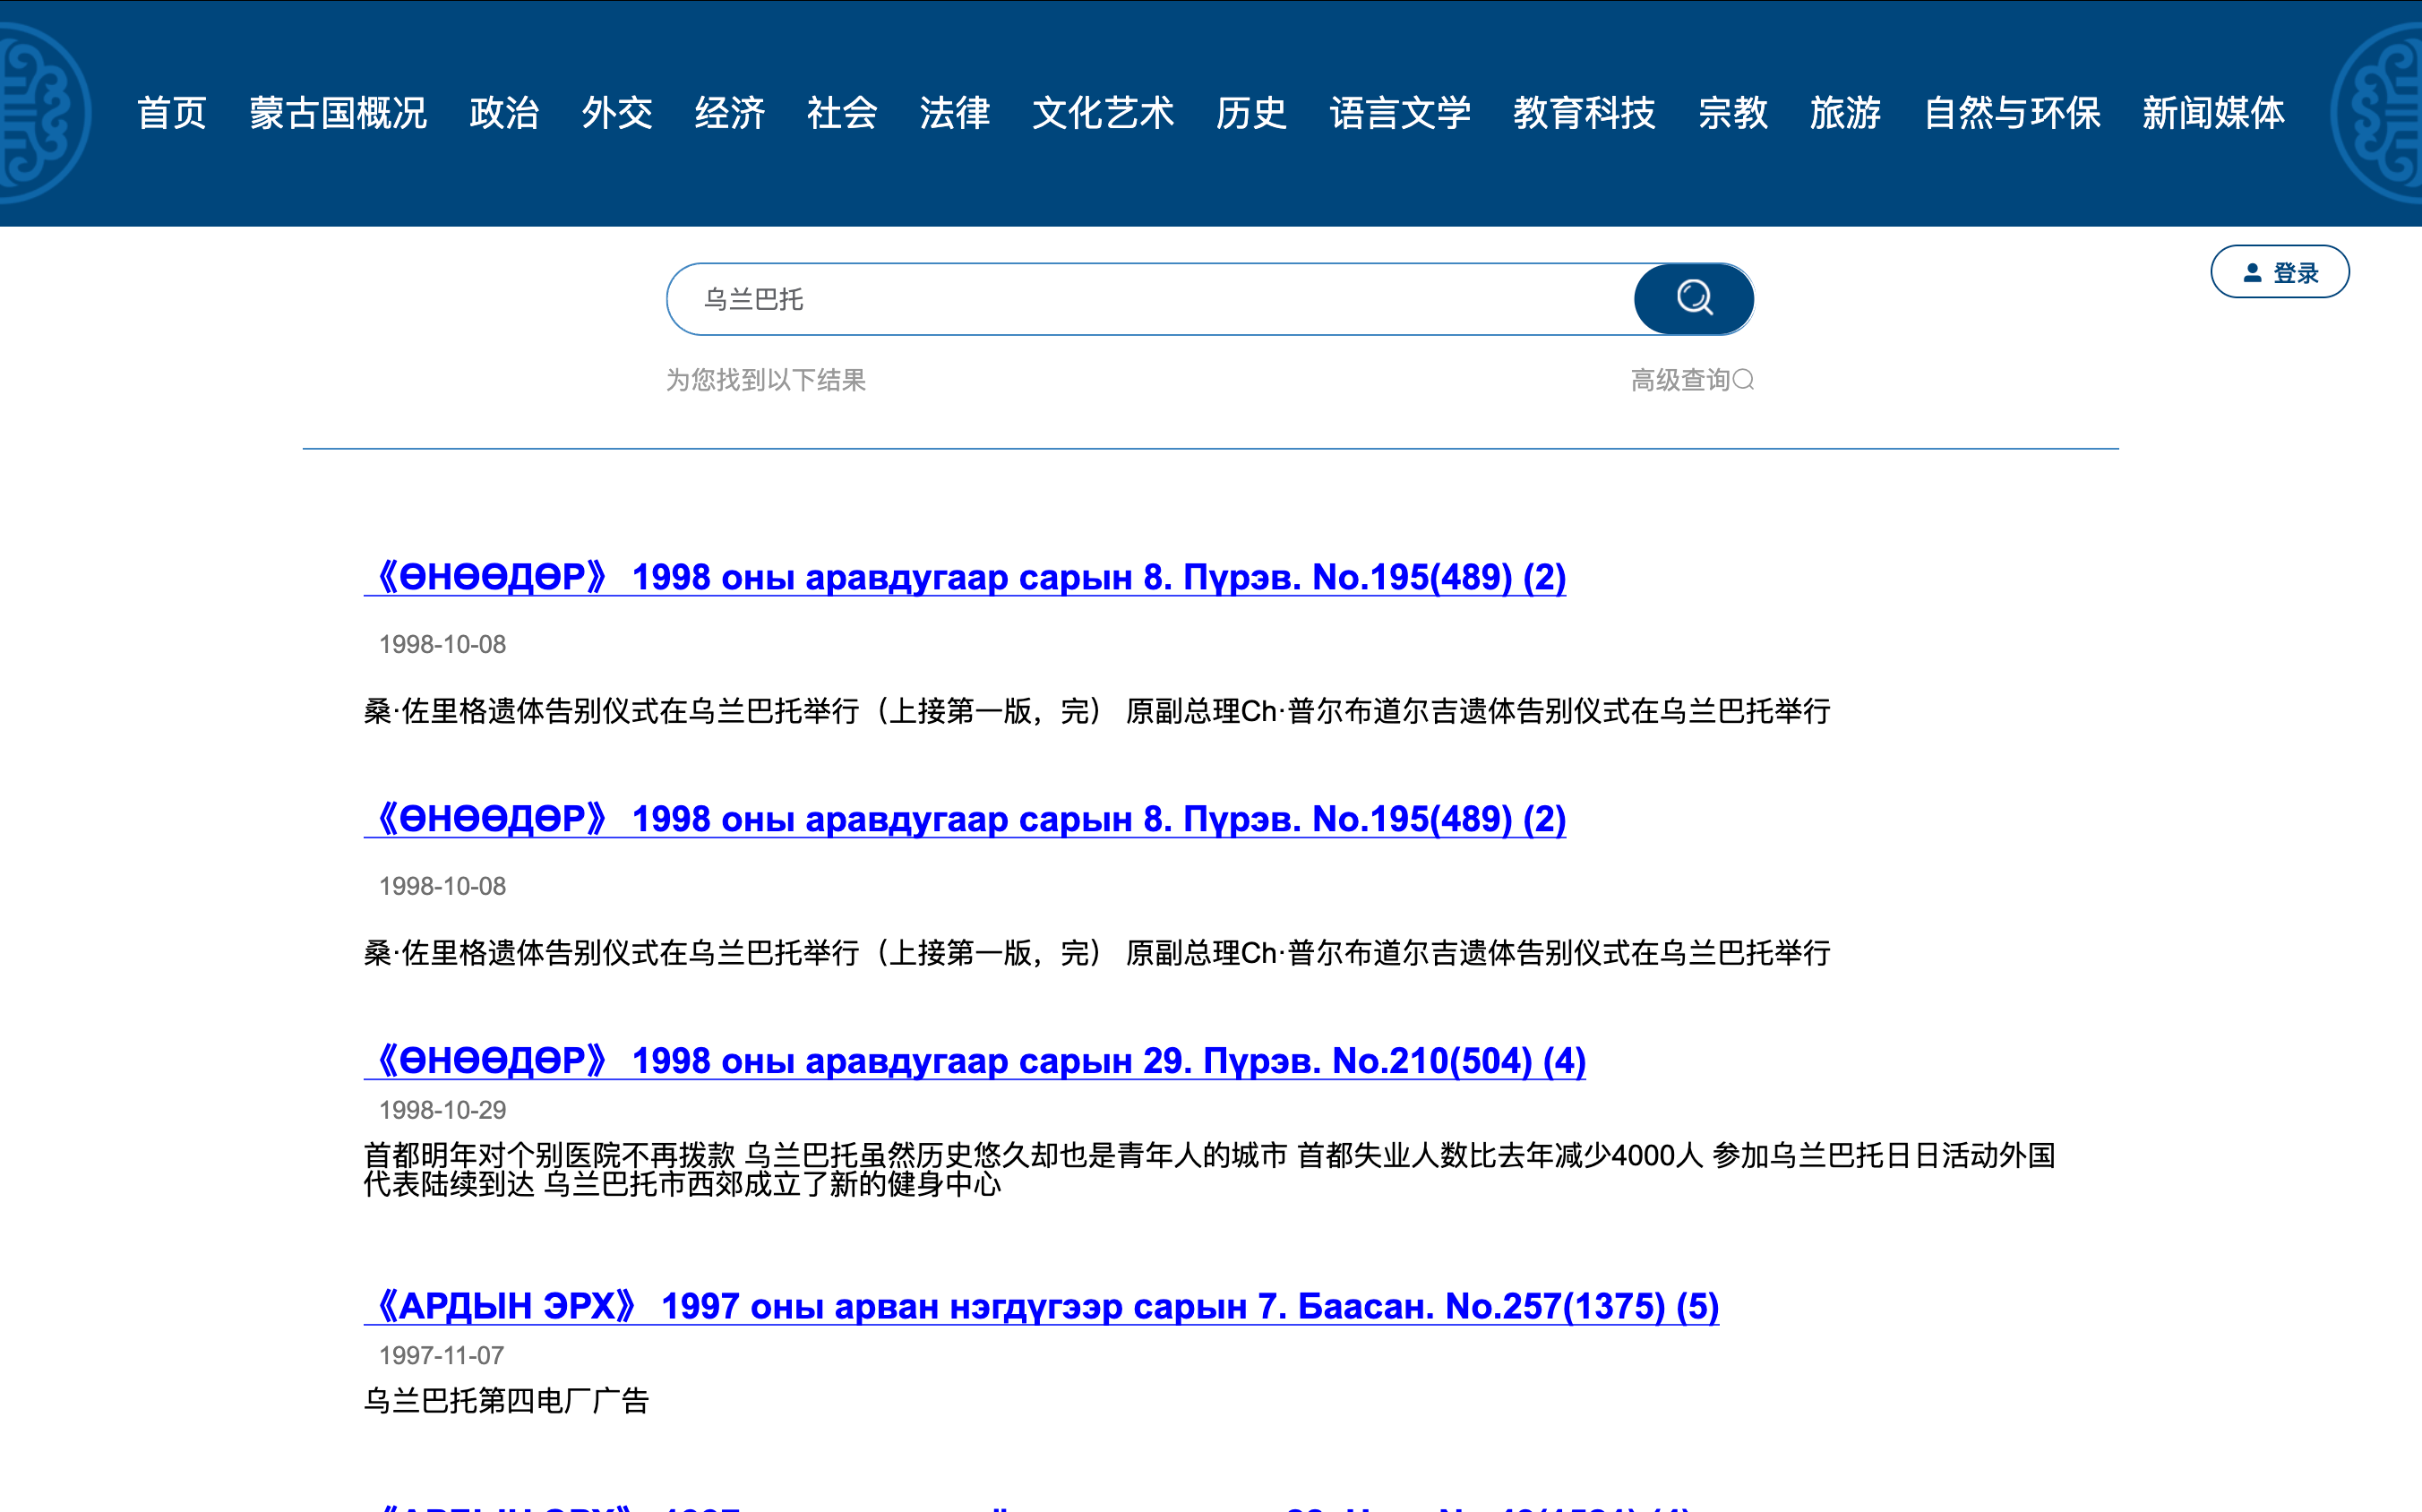
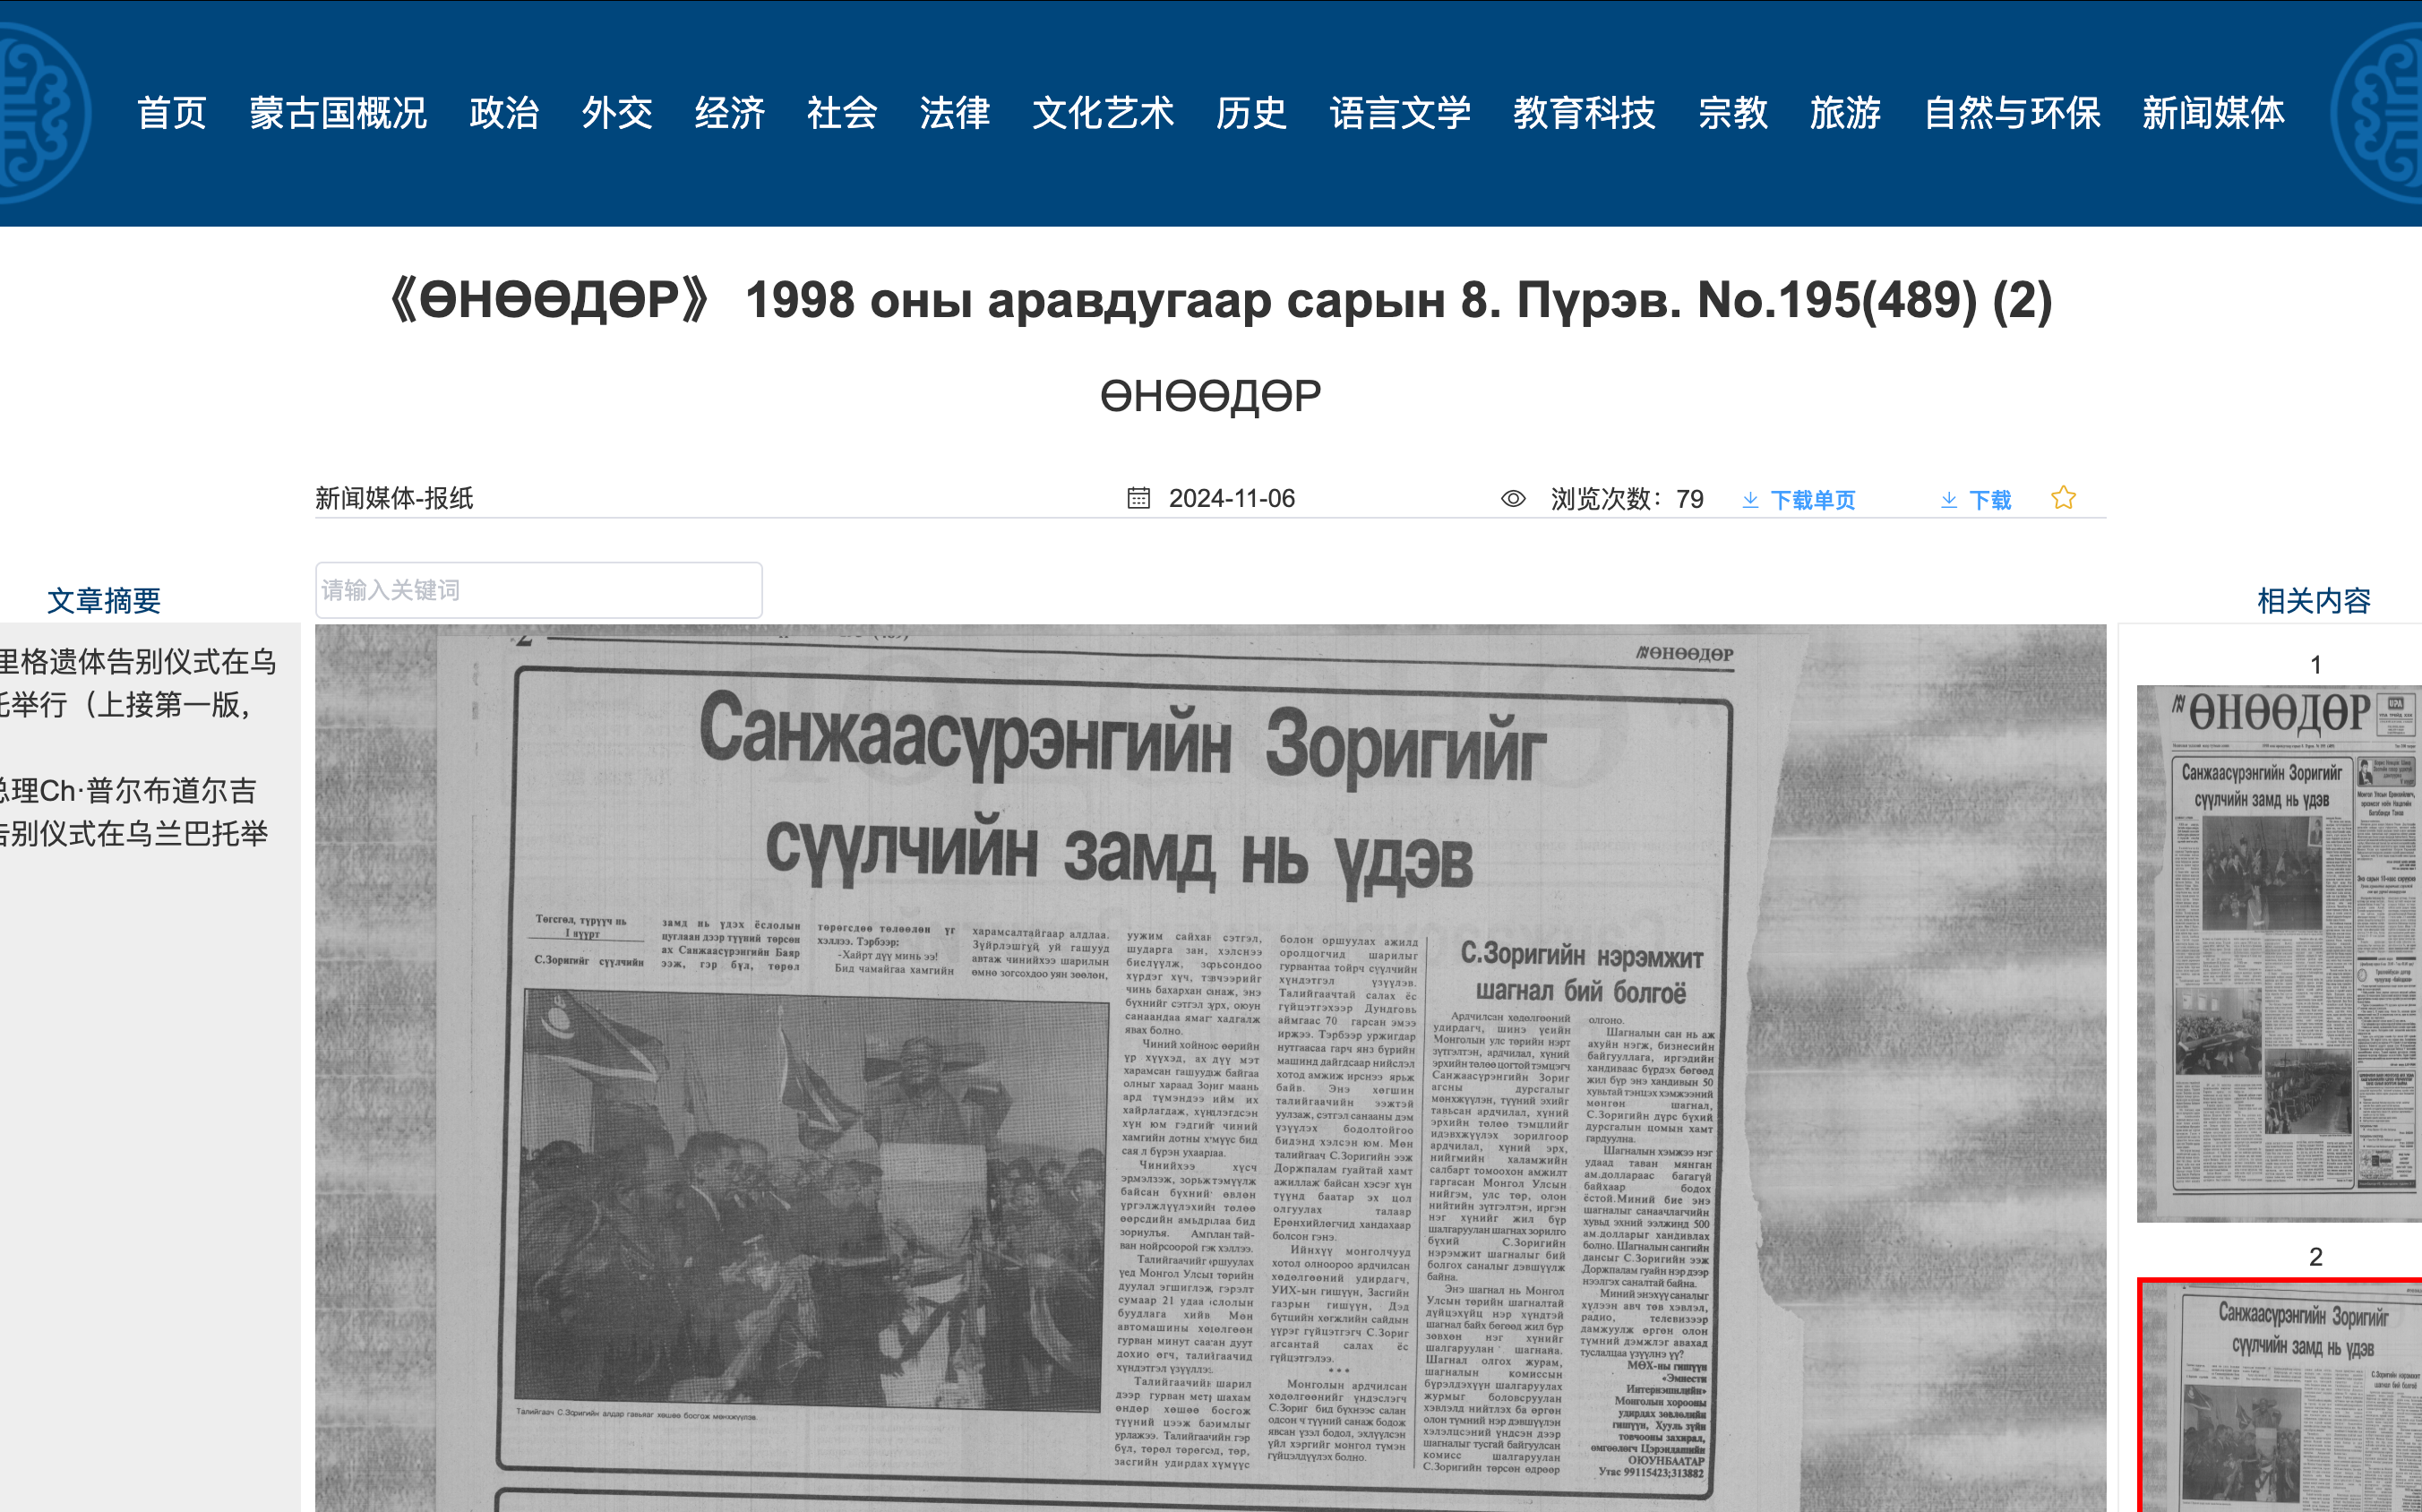
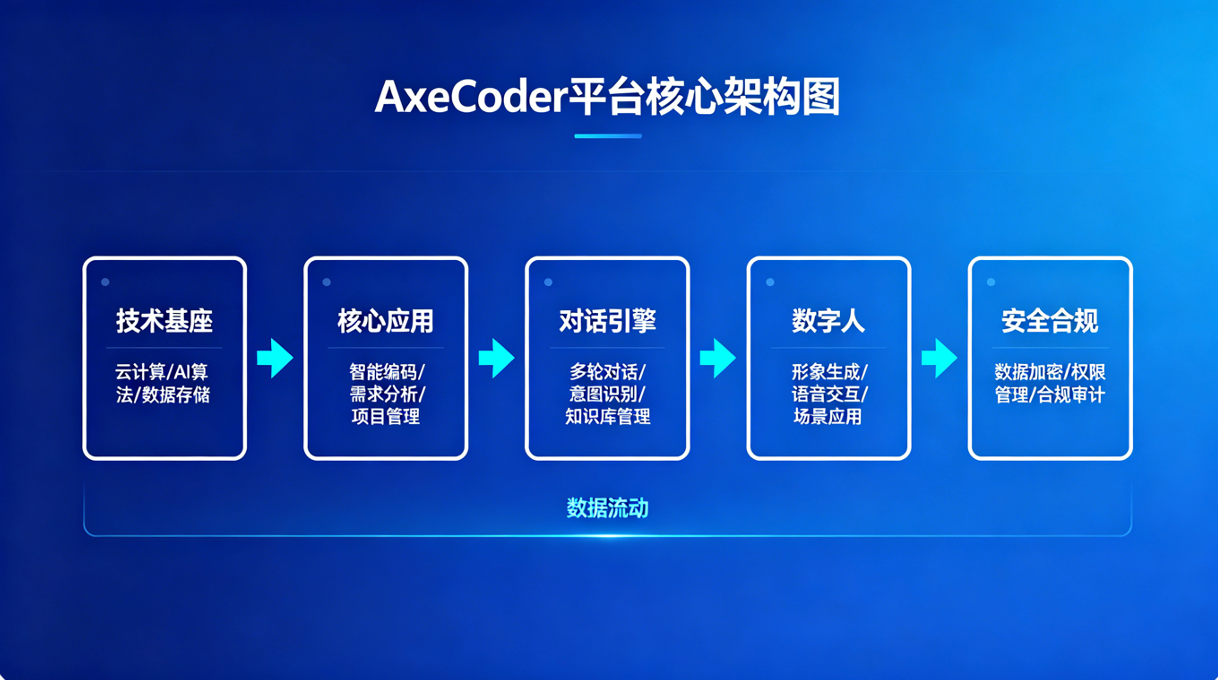
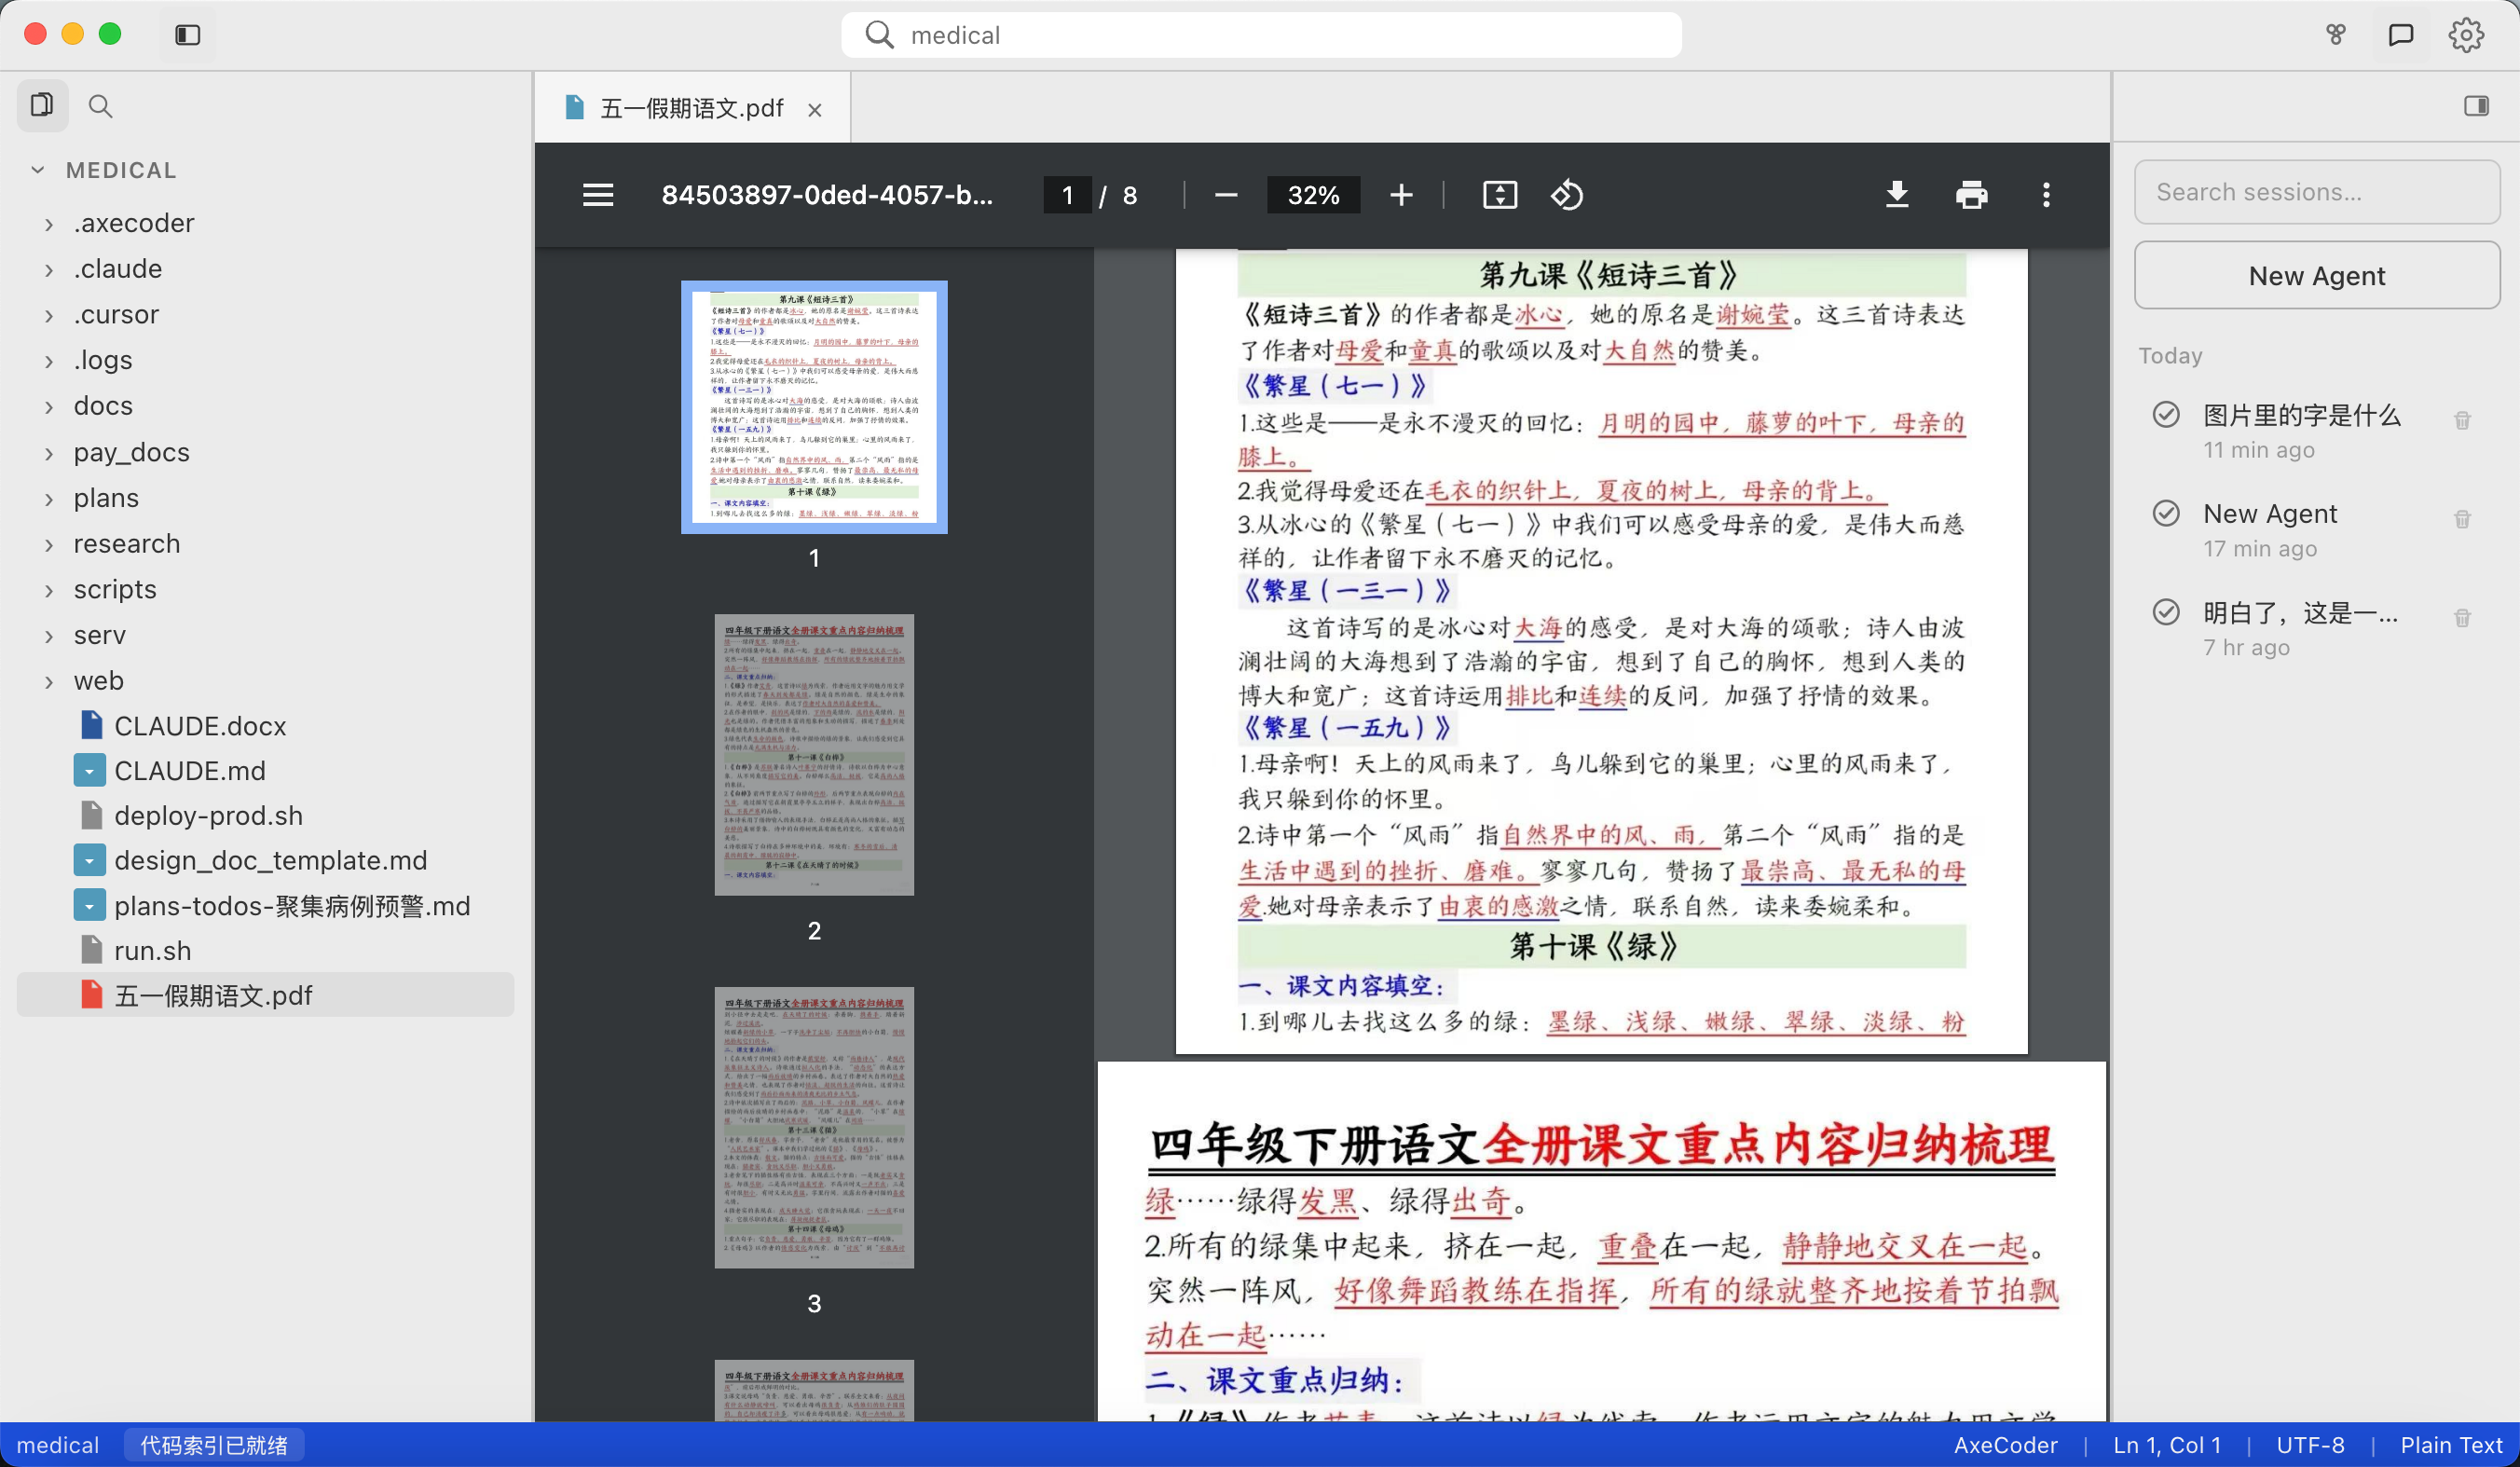
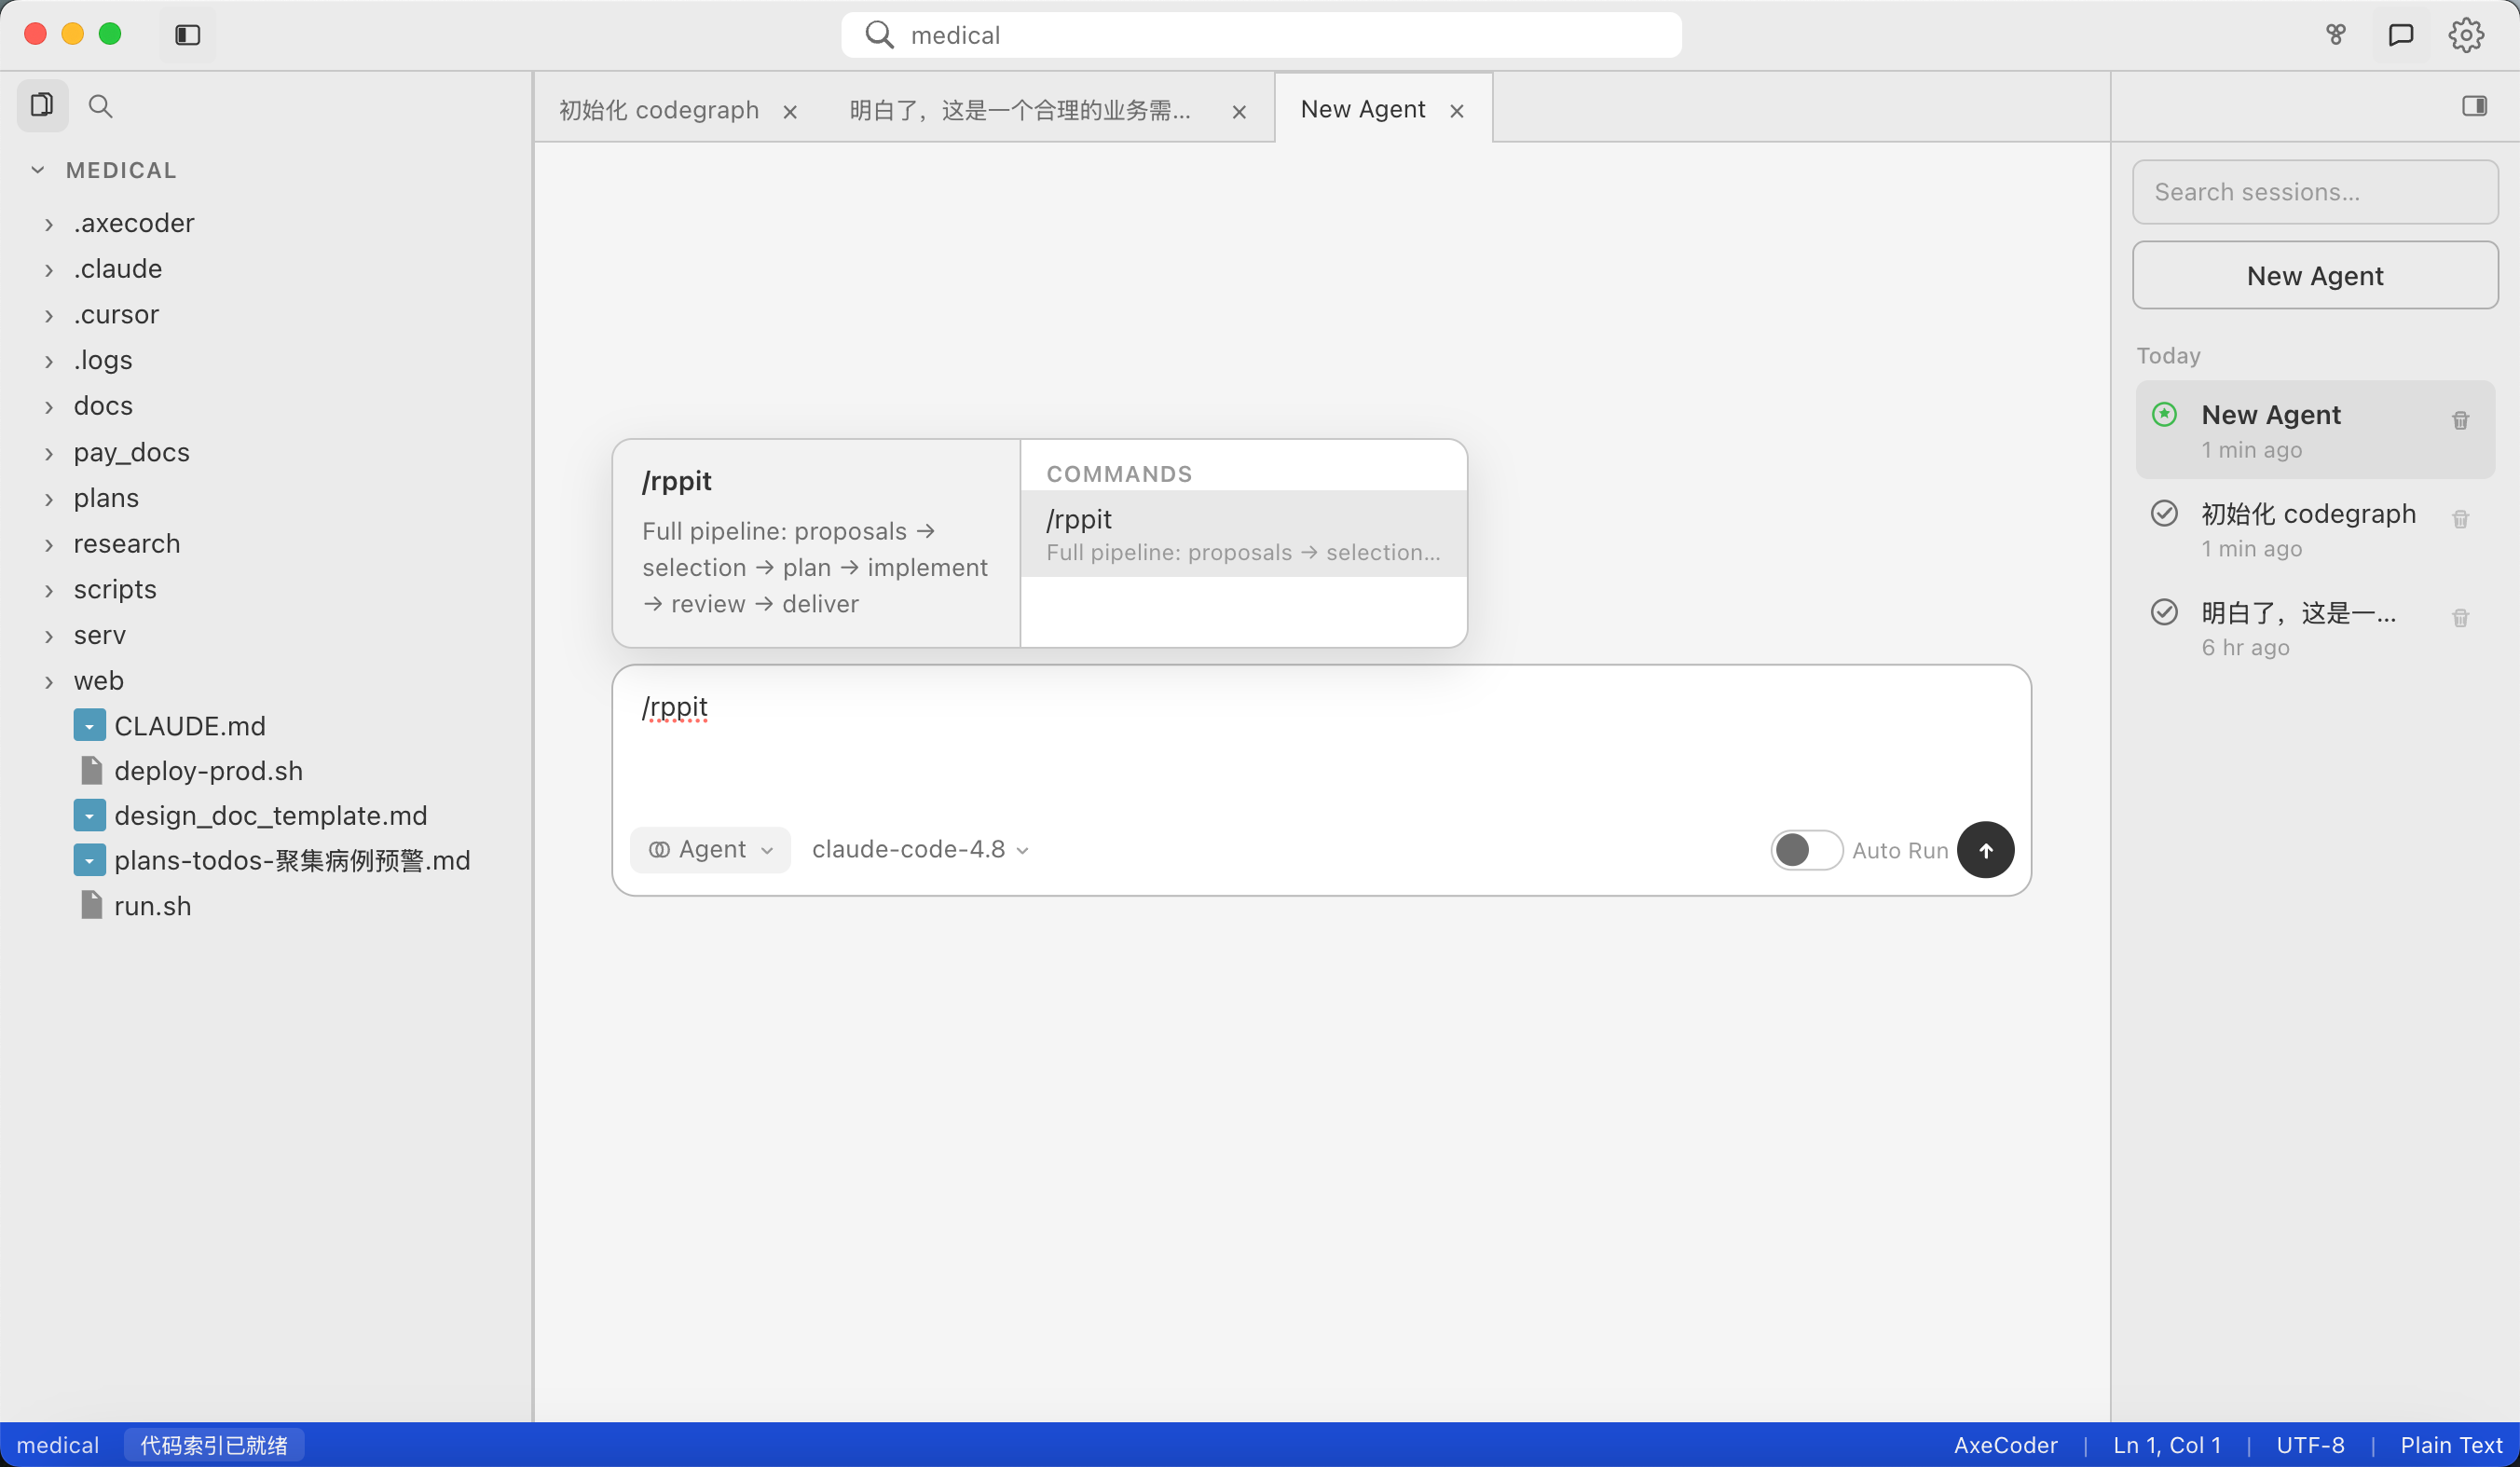
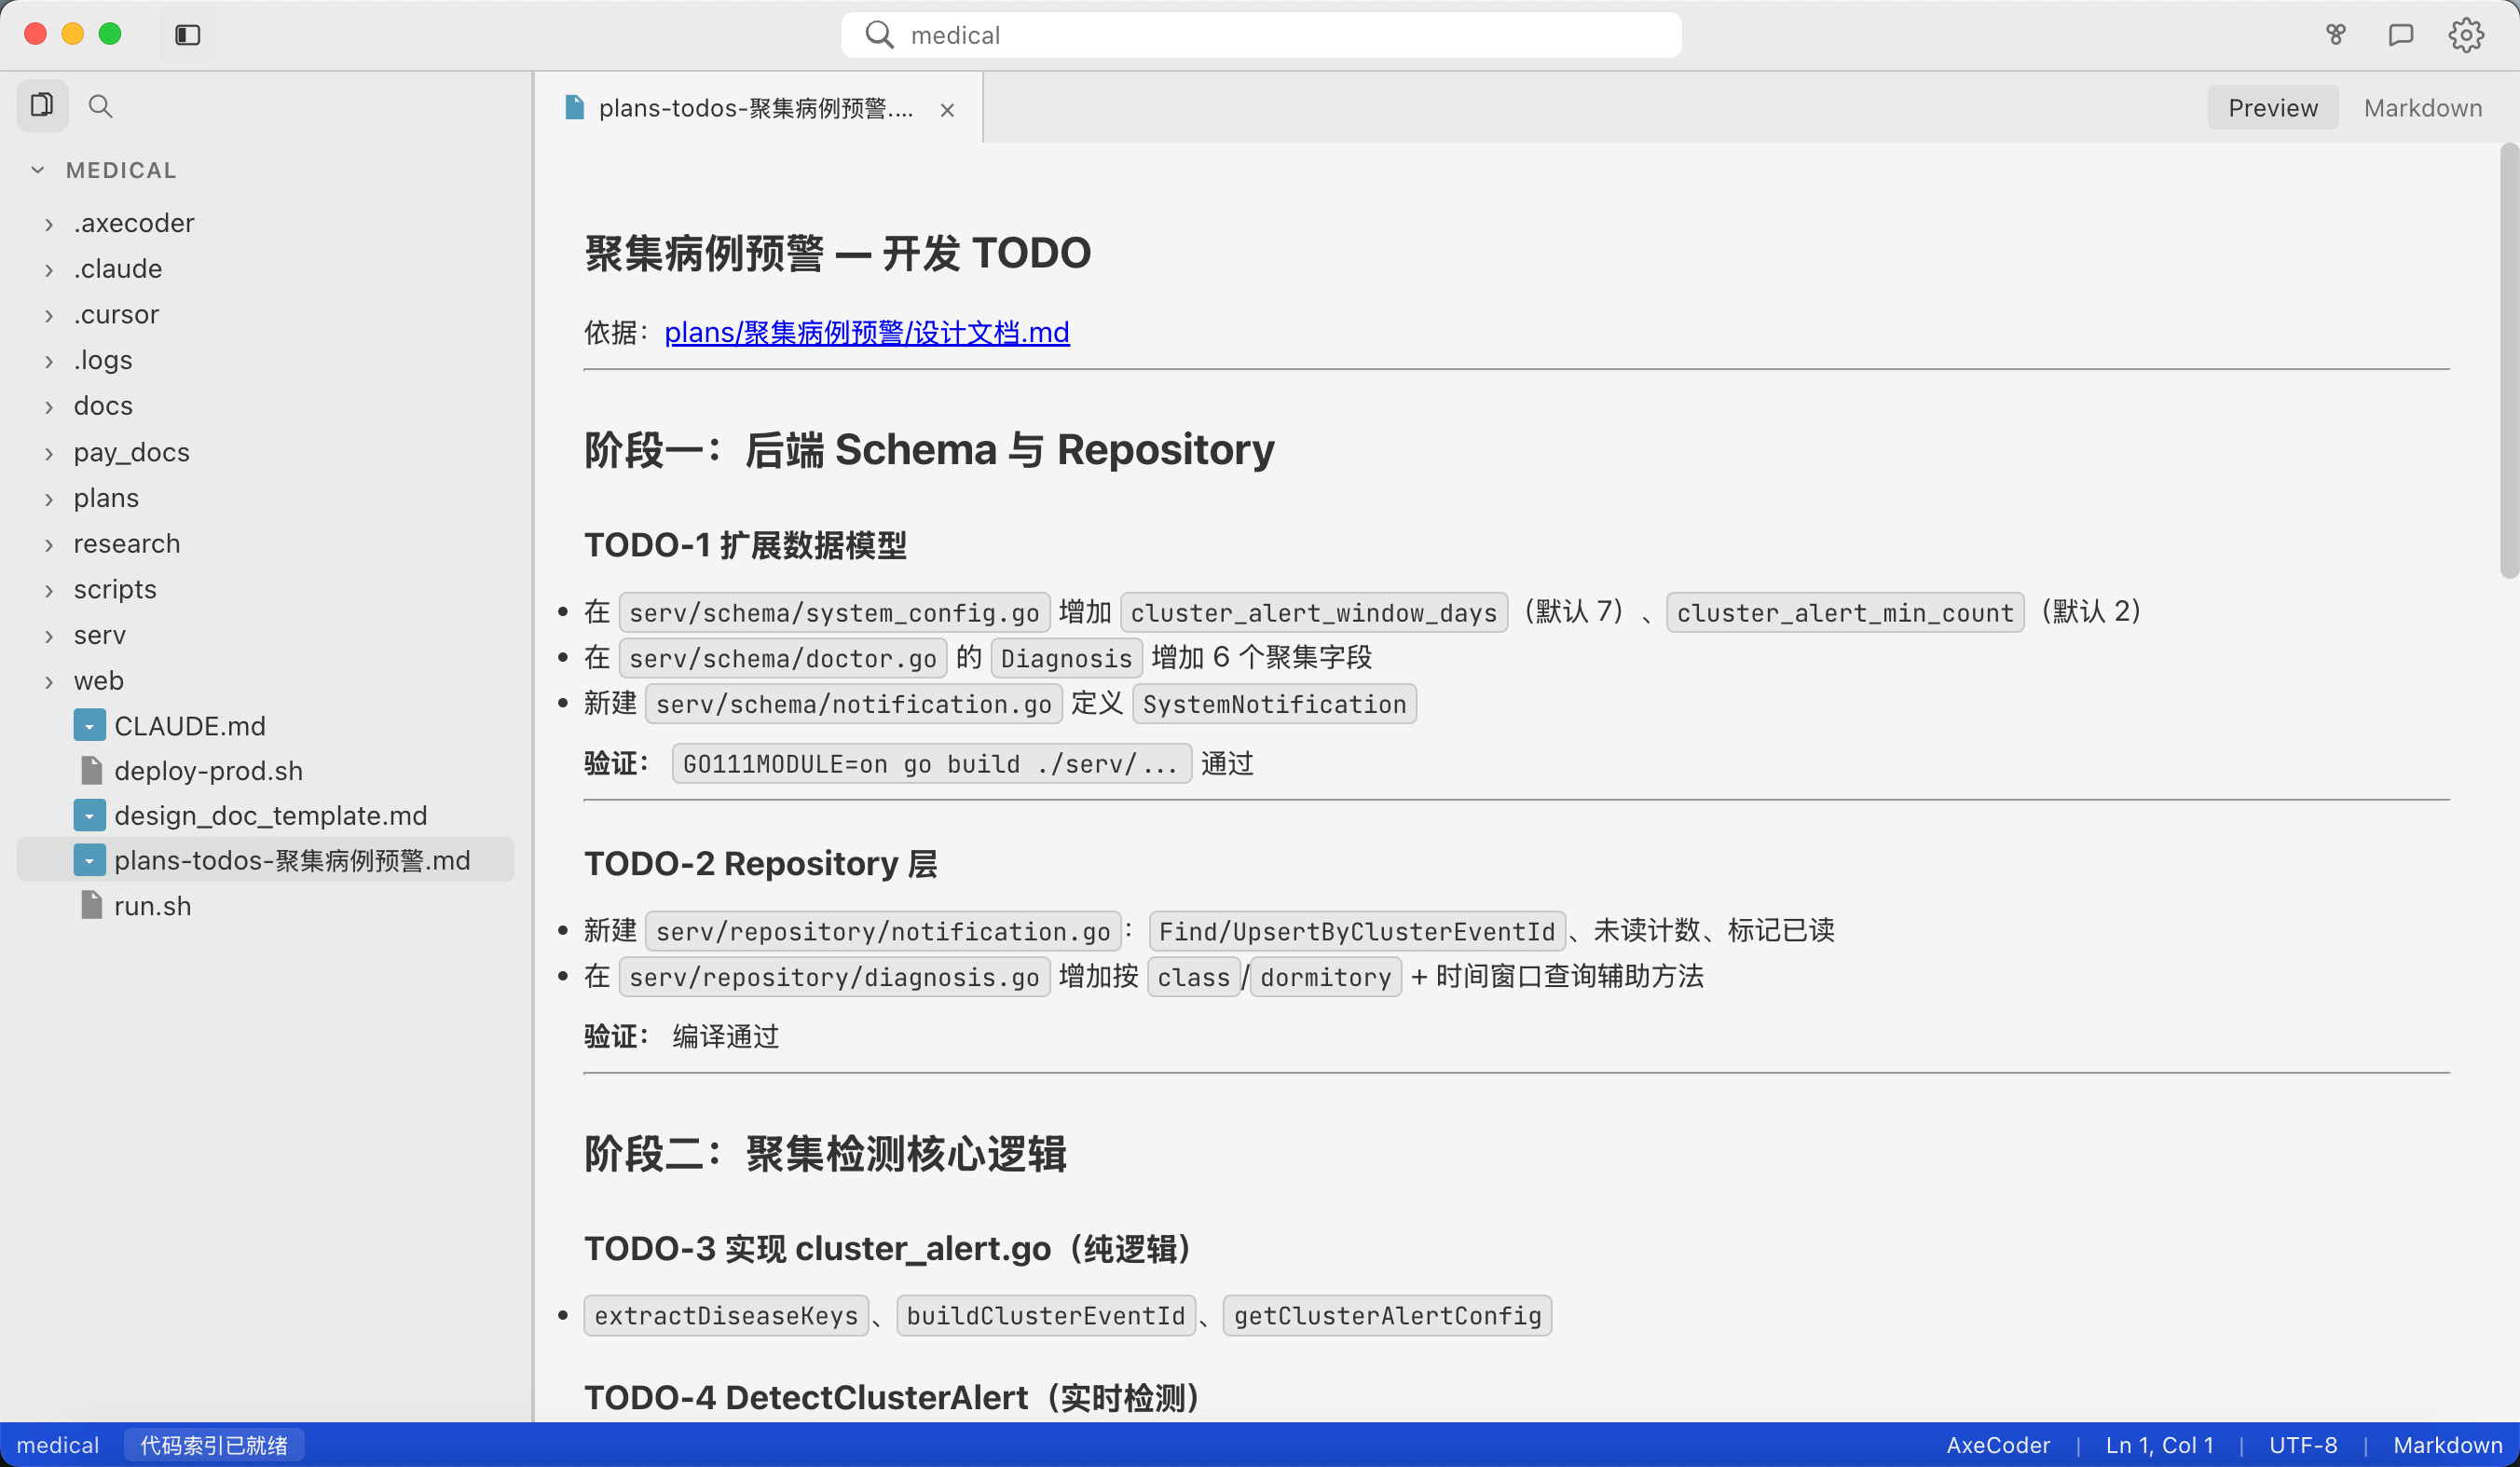
构建知识库时,支持文本、文档、网页链接等多源异构数据导入,配套问答库模板与批量导入功能(含 Excel / CSV)。内置文档识别服务:PDF 在线预览与正文抽取,Word 由 Mammoth 解析,Markdown / TXT 直接读取渲染;Word / PPT 等 Office 格式经 LibreOffice 无头转换为 PDF 后统一解析入库。扫描件以 Tesseract OCR 引擎识别转写(支持 TSV 版式输出),复杂版式文档配套可编辑标记工具校正后入库。左侧项目目录集中管理多格式文件,点选即可在主工作区按格式预览或编辑;右侧 Agent 会话联动目录文档,支持点选或拖拽注入上下文,实现「文档入库—格式解析—智能问答」闭环。
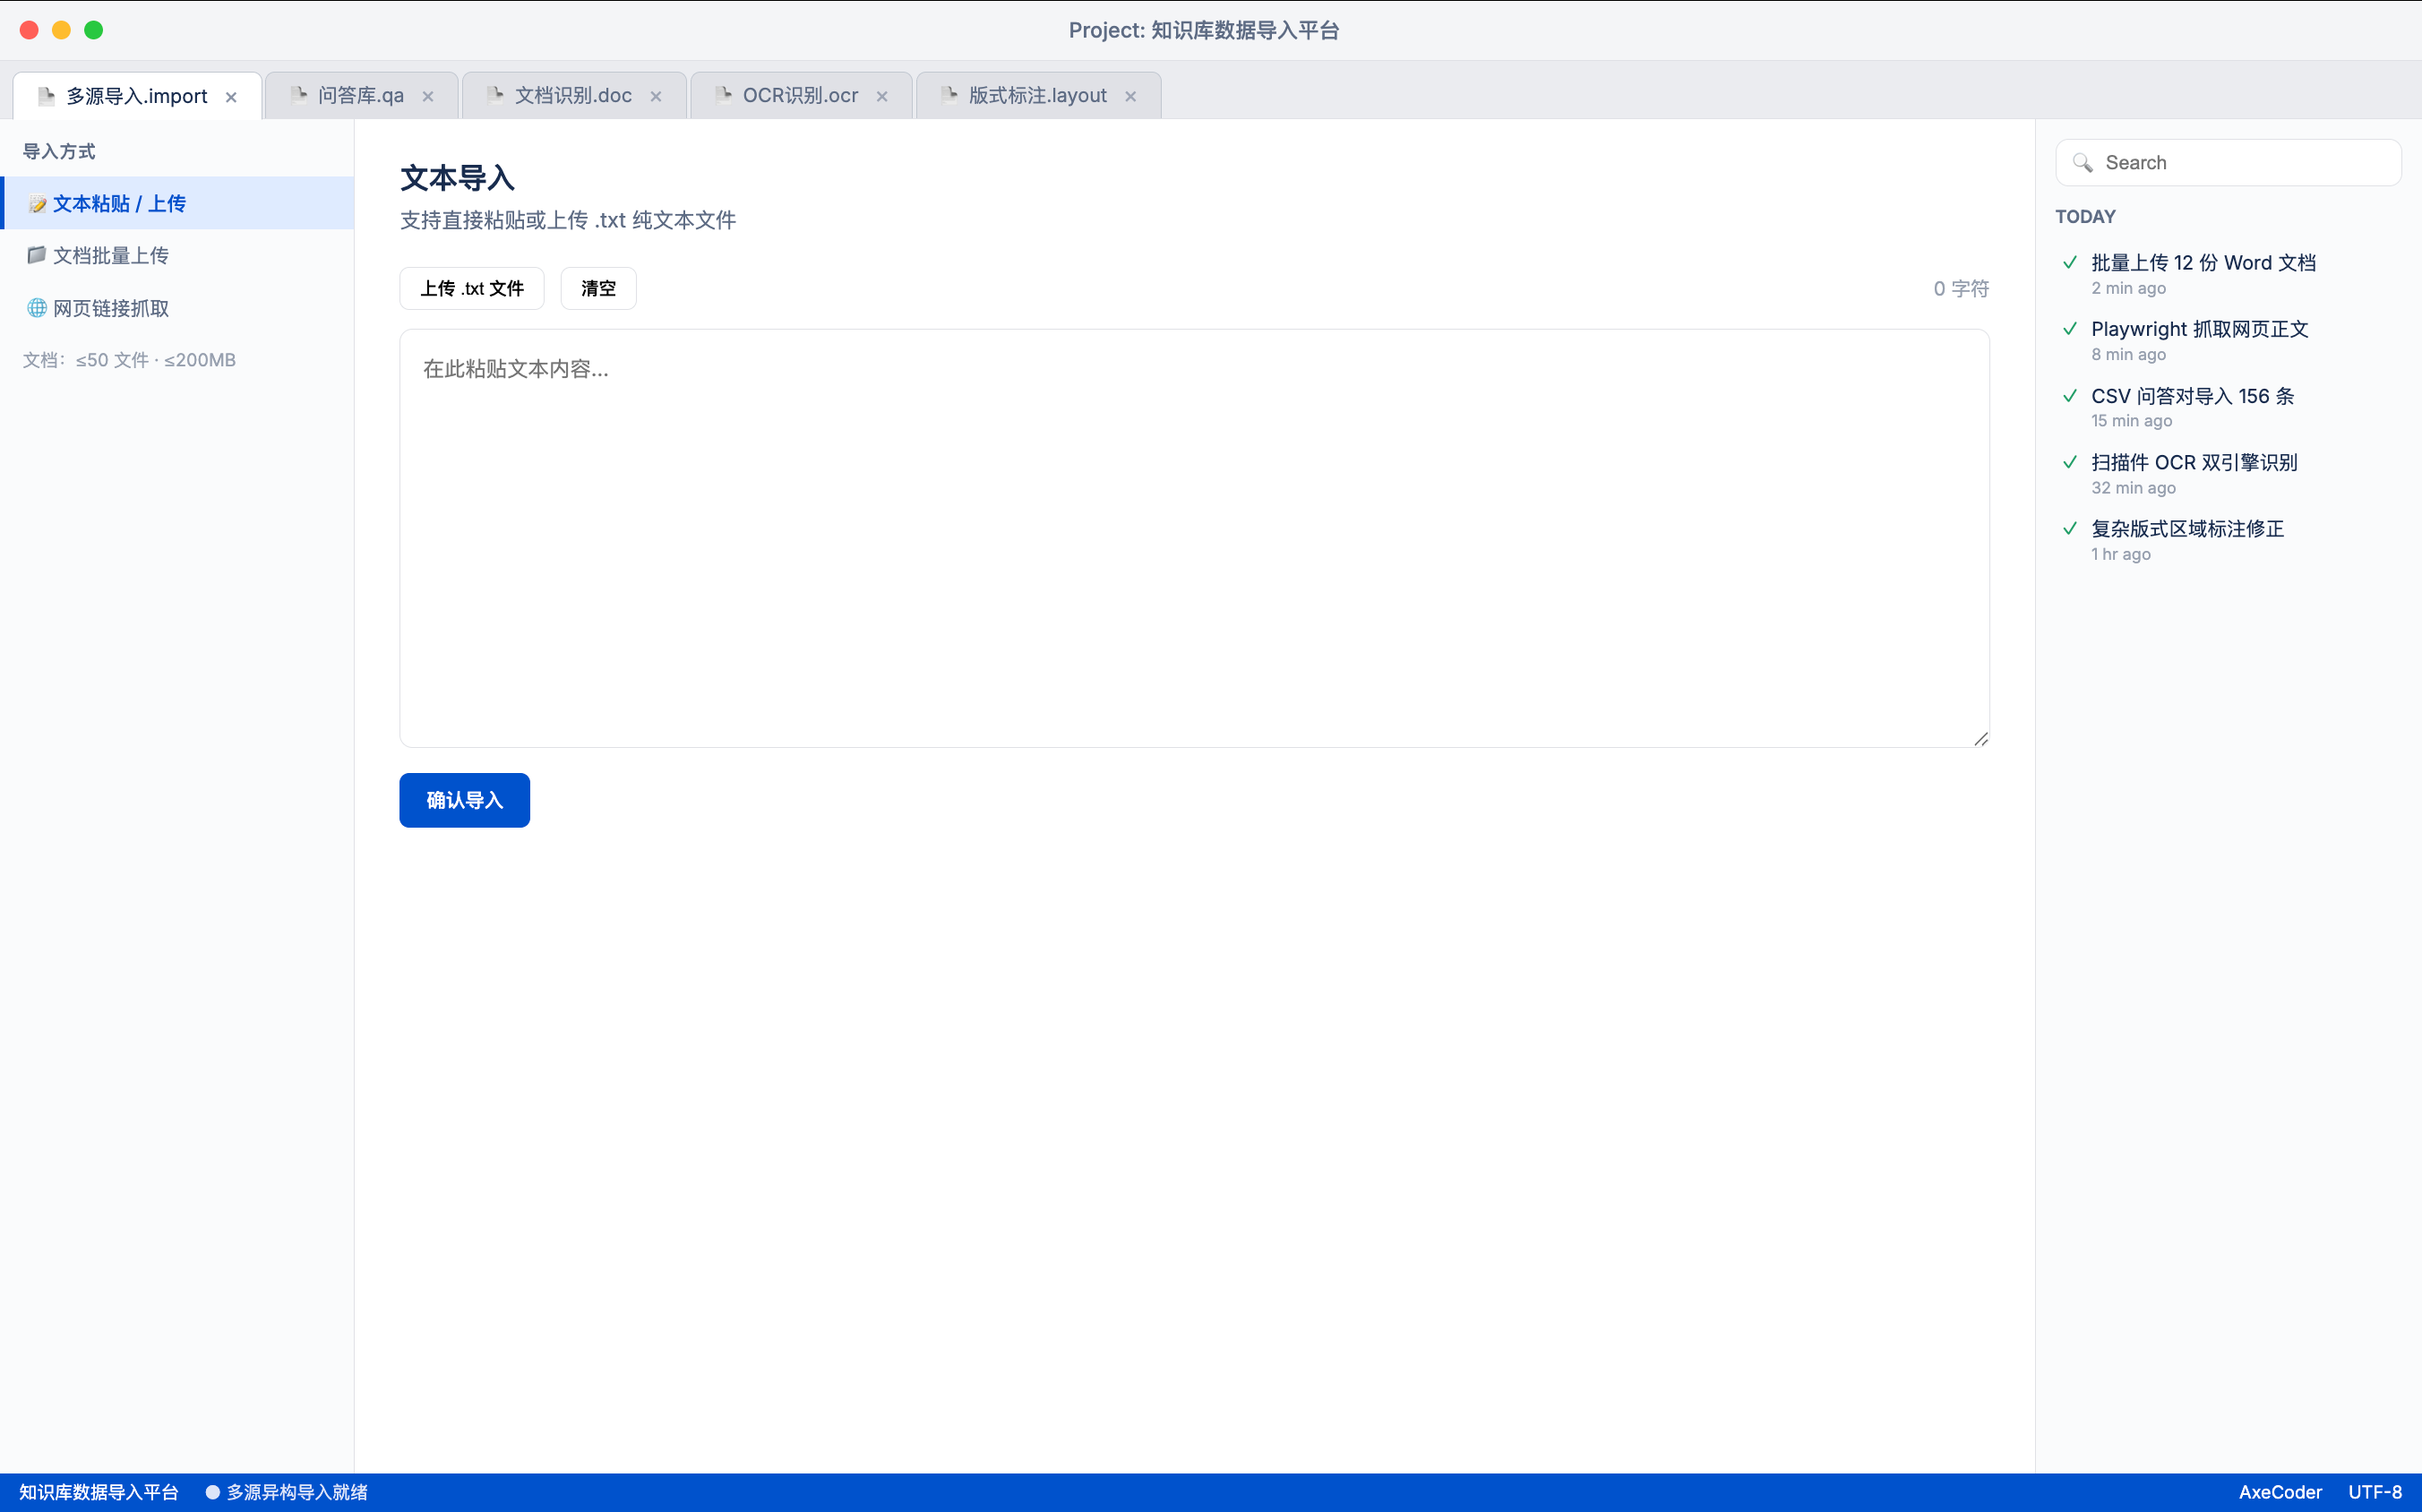
在多源异构数据导入方面,文本支持直接粘贴或上传纯文本文件;文档支持通过拖拽或文件选择器批量上传(单次不超过 50 个文件、总大小不超过 200MB);网页链接输入 URL 后,由 Playwright 无头浏览器自动抓取动态渲染网页内容,并提取正文、去除广告导航等噪声。平台提供统一导入工作台,左侧切换导入方式,右侧实时记录操作历史,便于追溯每次入库任务。
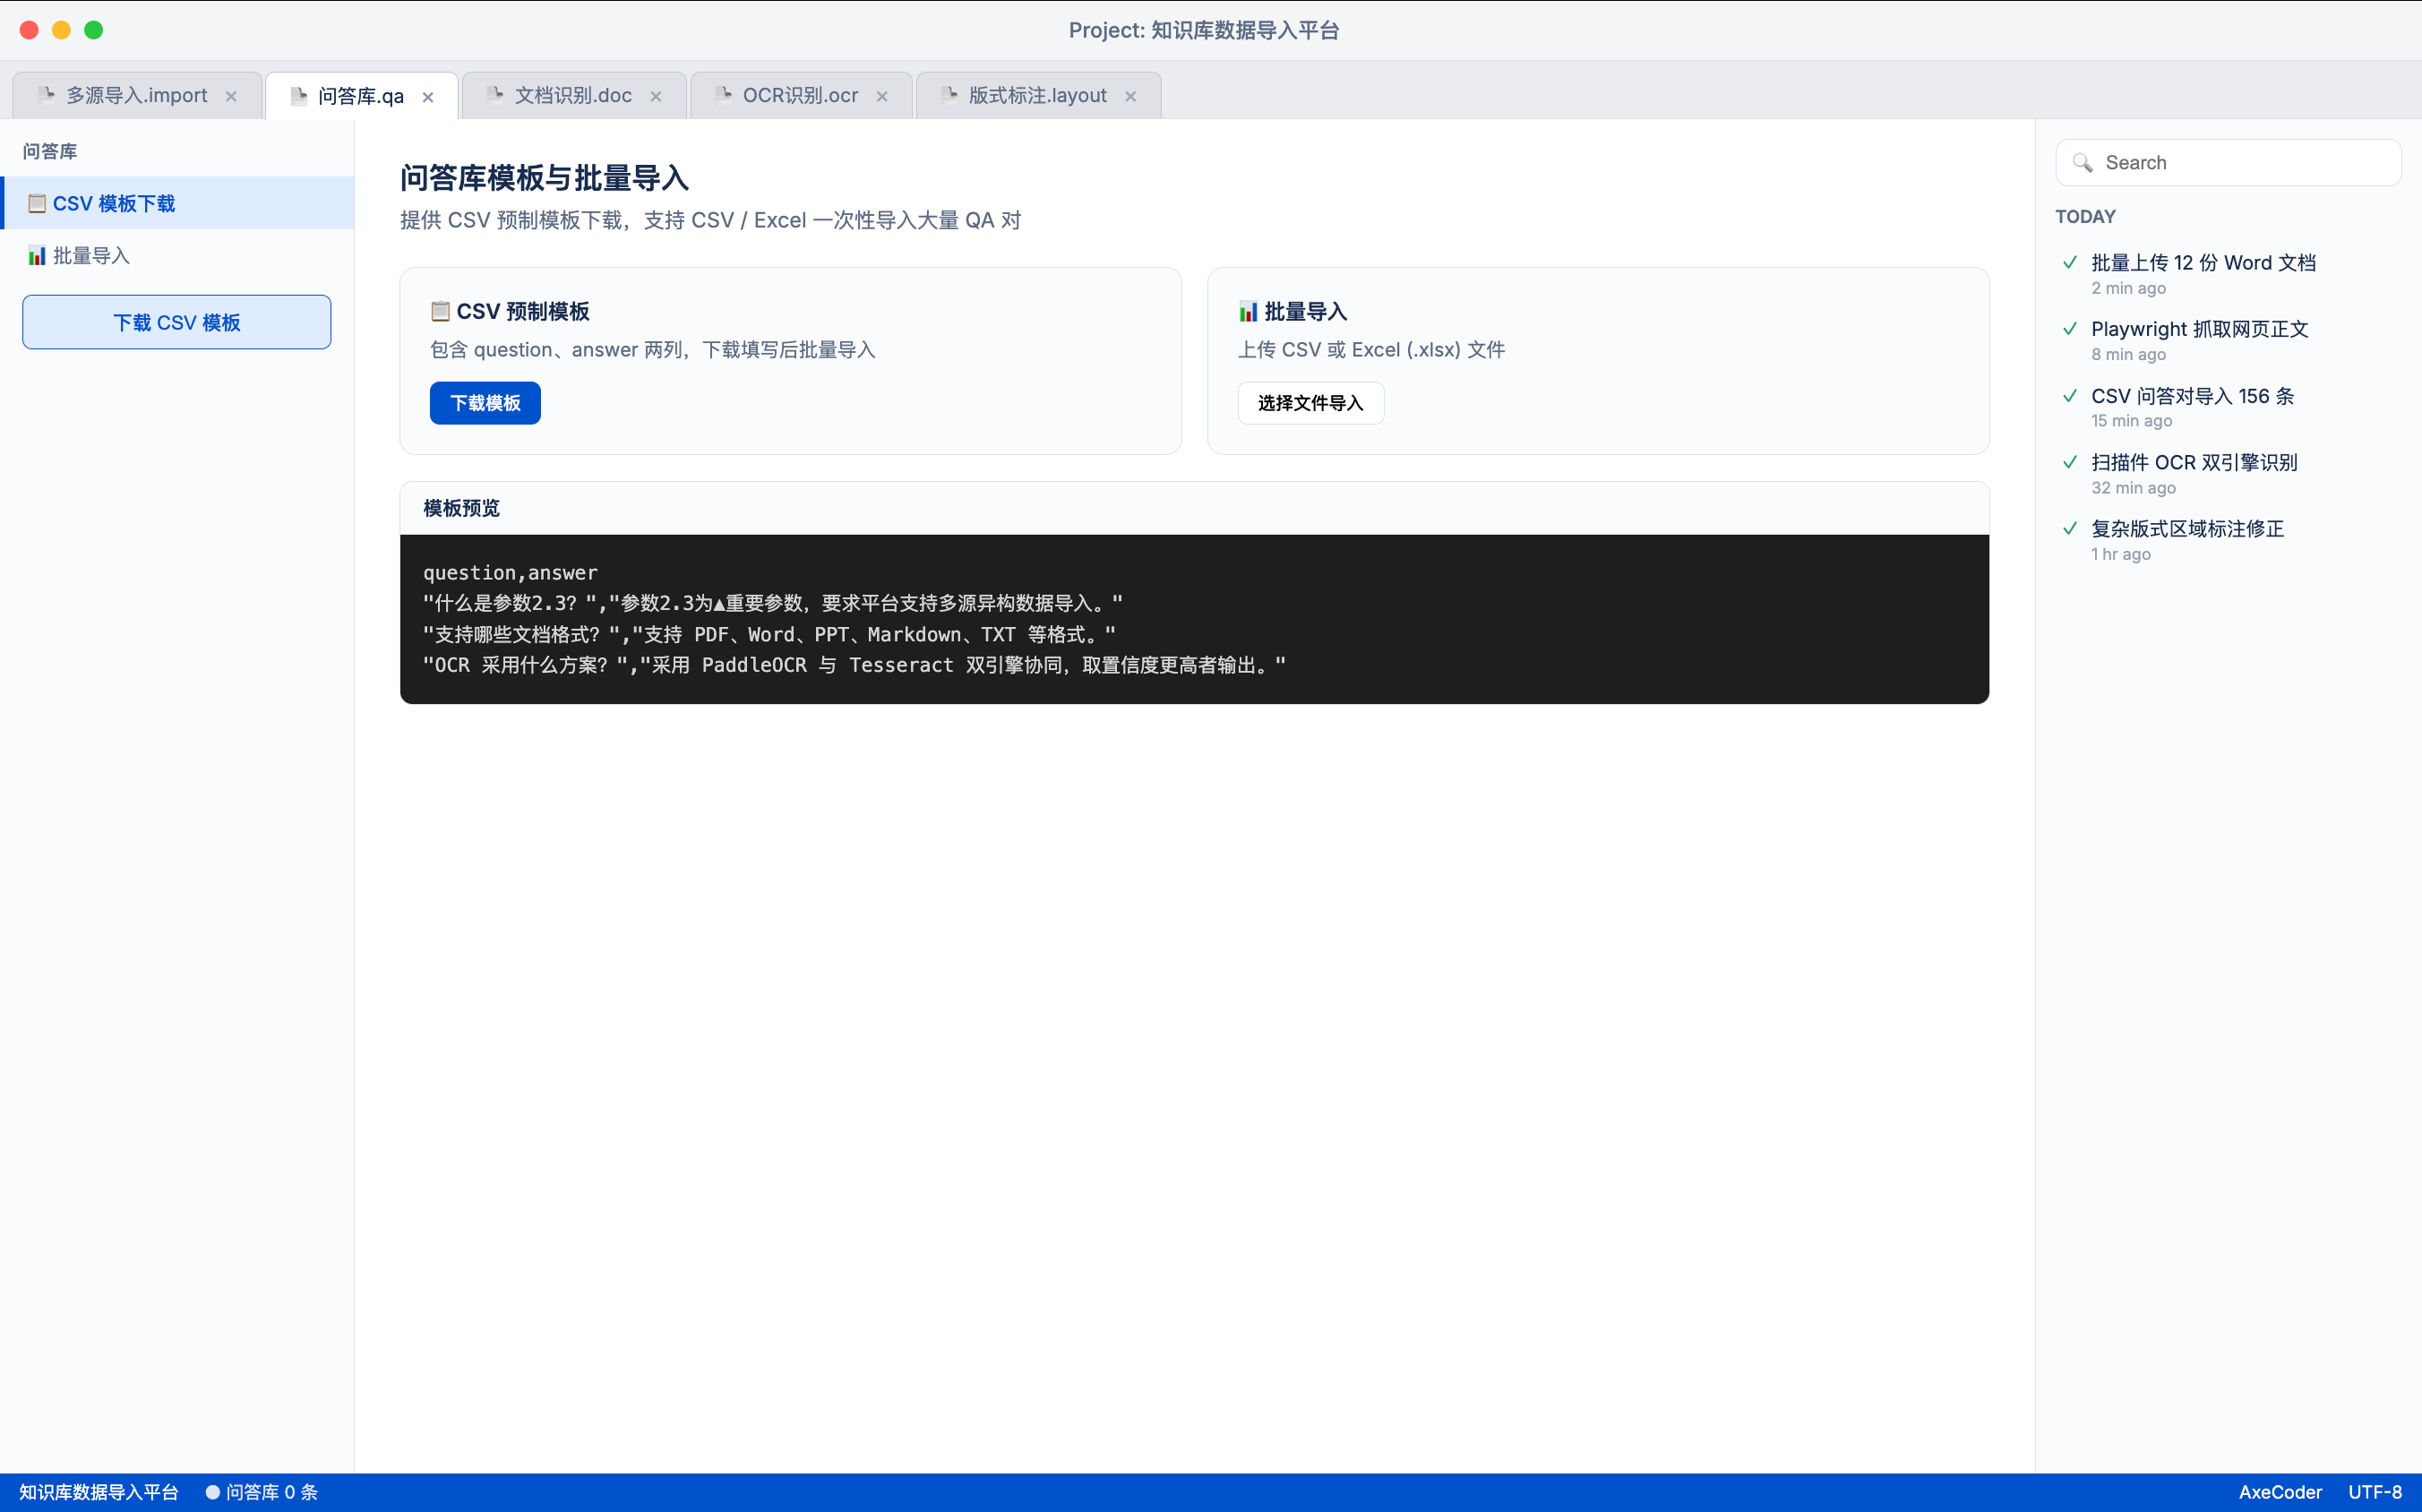
在问答库模板方面,提供 CSV 预制模板供用户下载,填写「问题」「答案」两列后即可批量导入;批量导入模块同时支持上传 CSV 或 Excel(.xlsx)文件,一次性导入大量 QA 对,模板预览区展示标准格式示例,降低结构化知识录入门槛。
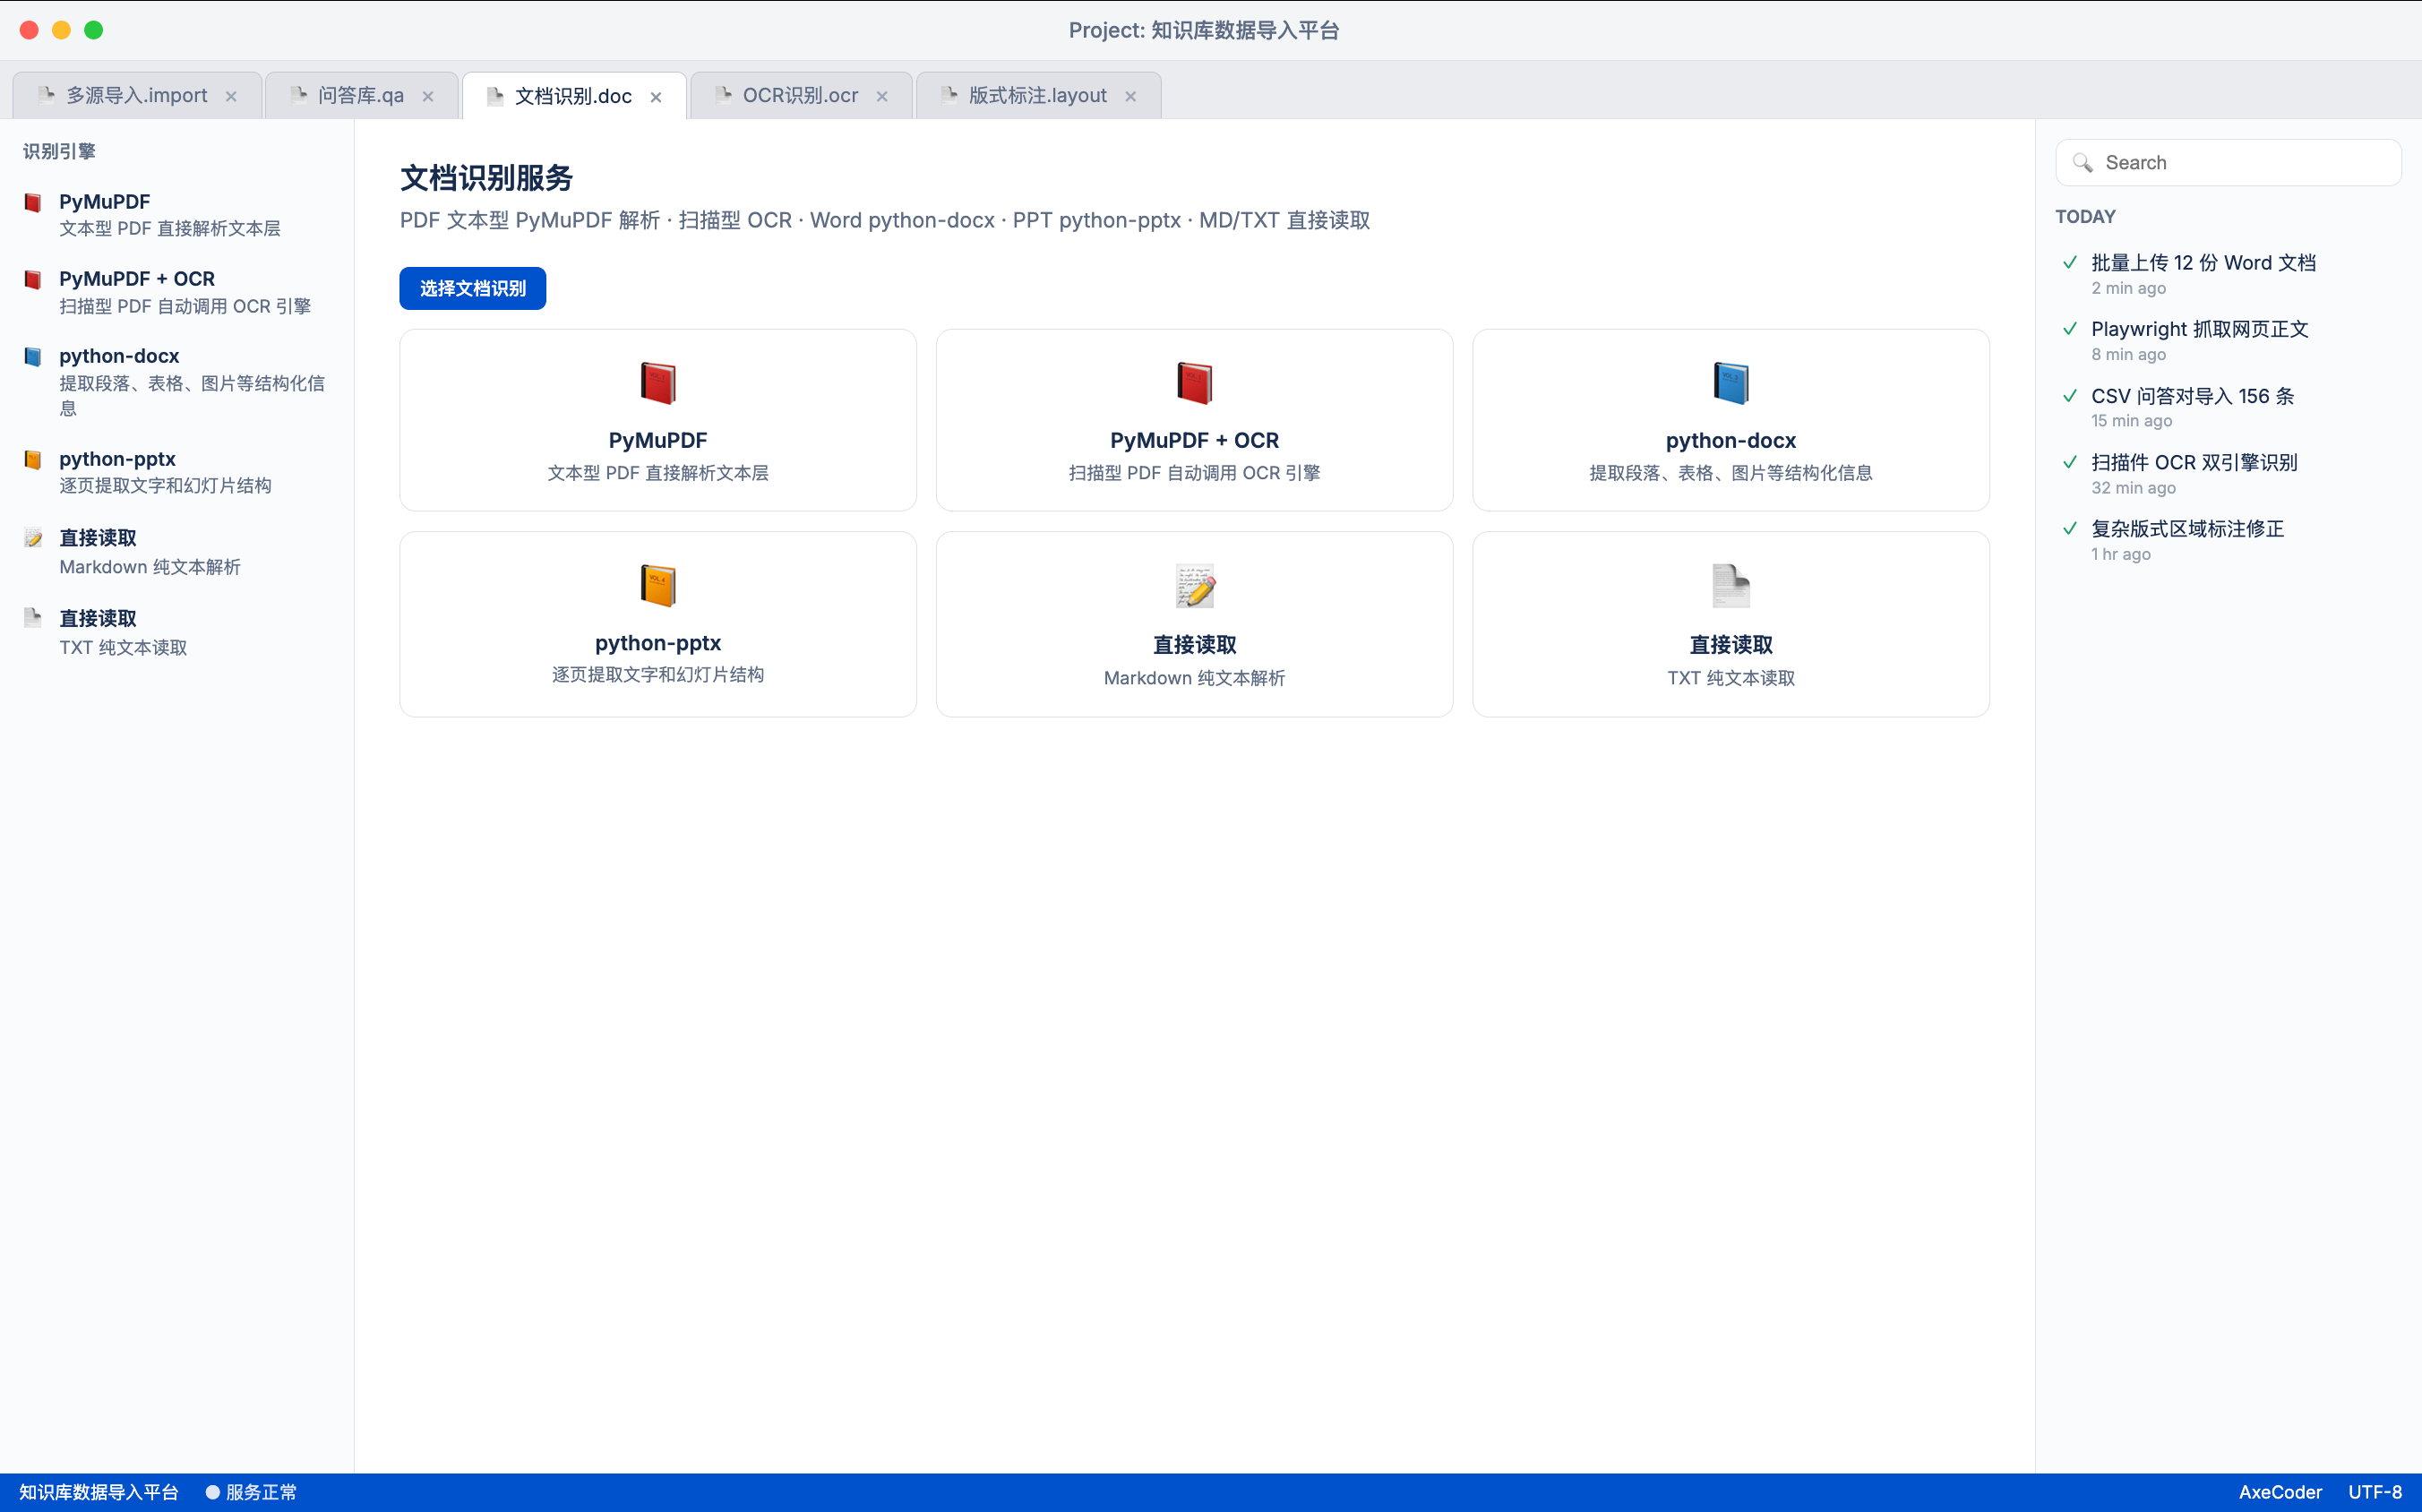
在文档识别服务方面,PDF 文本型使用 PyMuPDF 解析文本层,扫描型自动调用 OCR 引擎识别;Word 使用 python-docx 解析,提取段落、表格、图片等结构化信息;PPT 使用 python-pptx 逐页提取文字和结构;Markdown 与 TXT 直接文本读取。各格式按文件类型自动匹配识别引擎,解析结果统一入库供检索与问答调用。
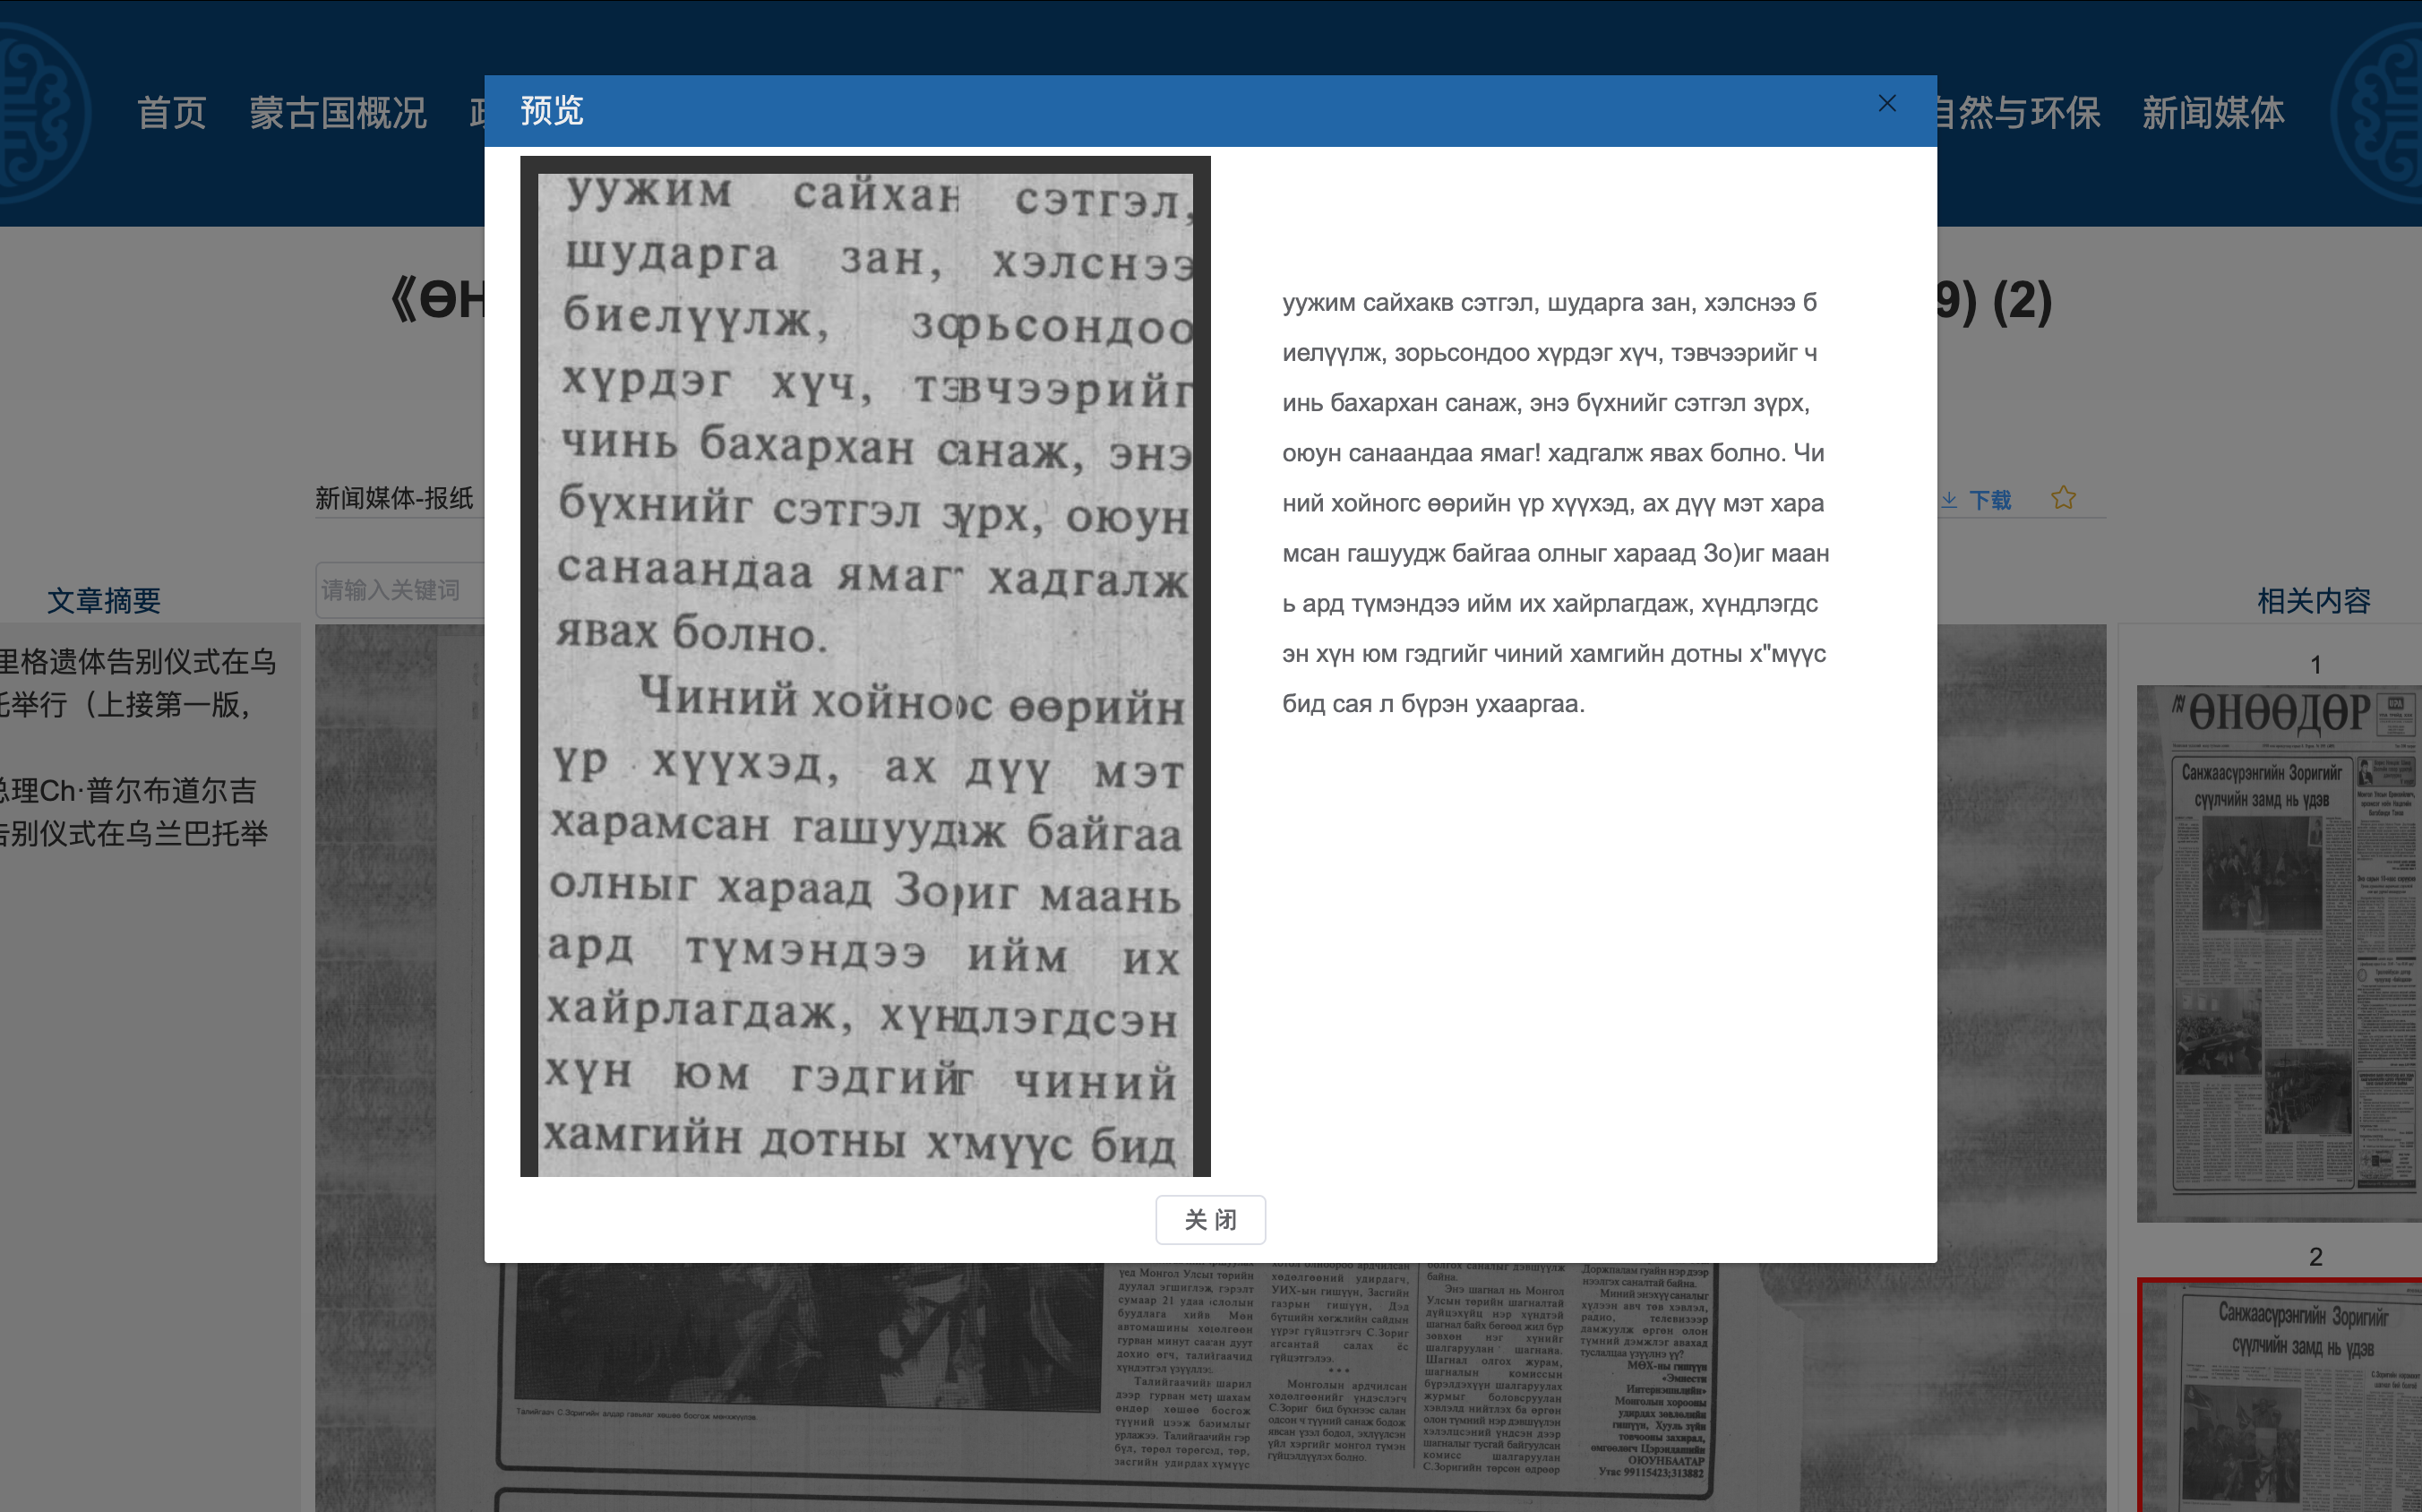
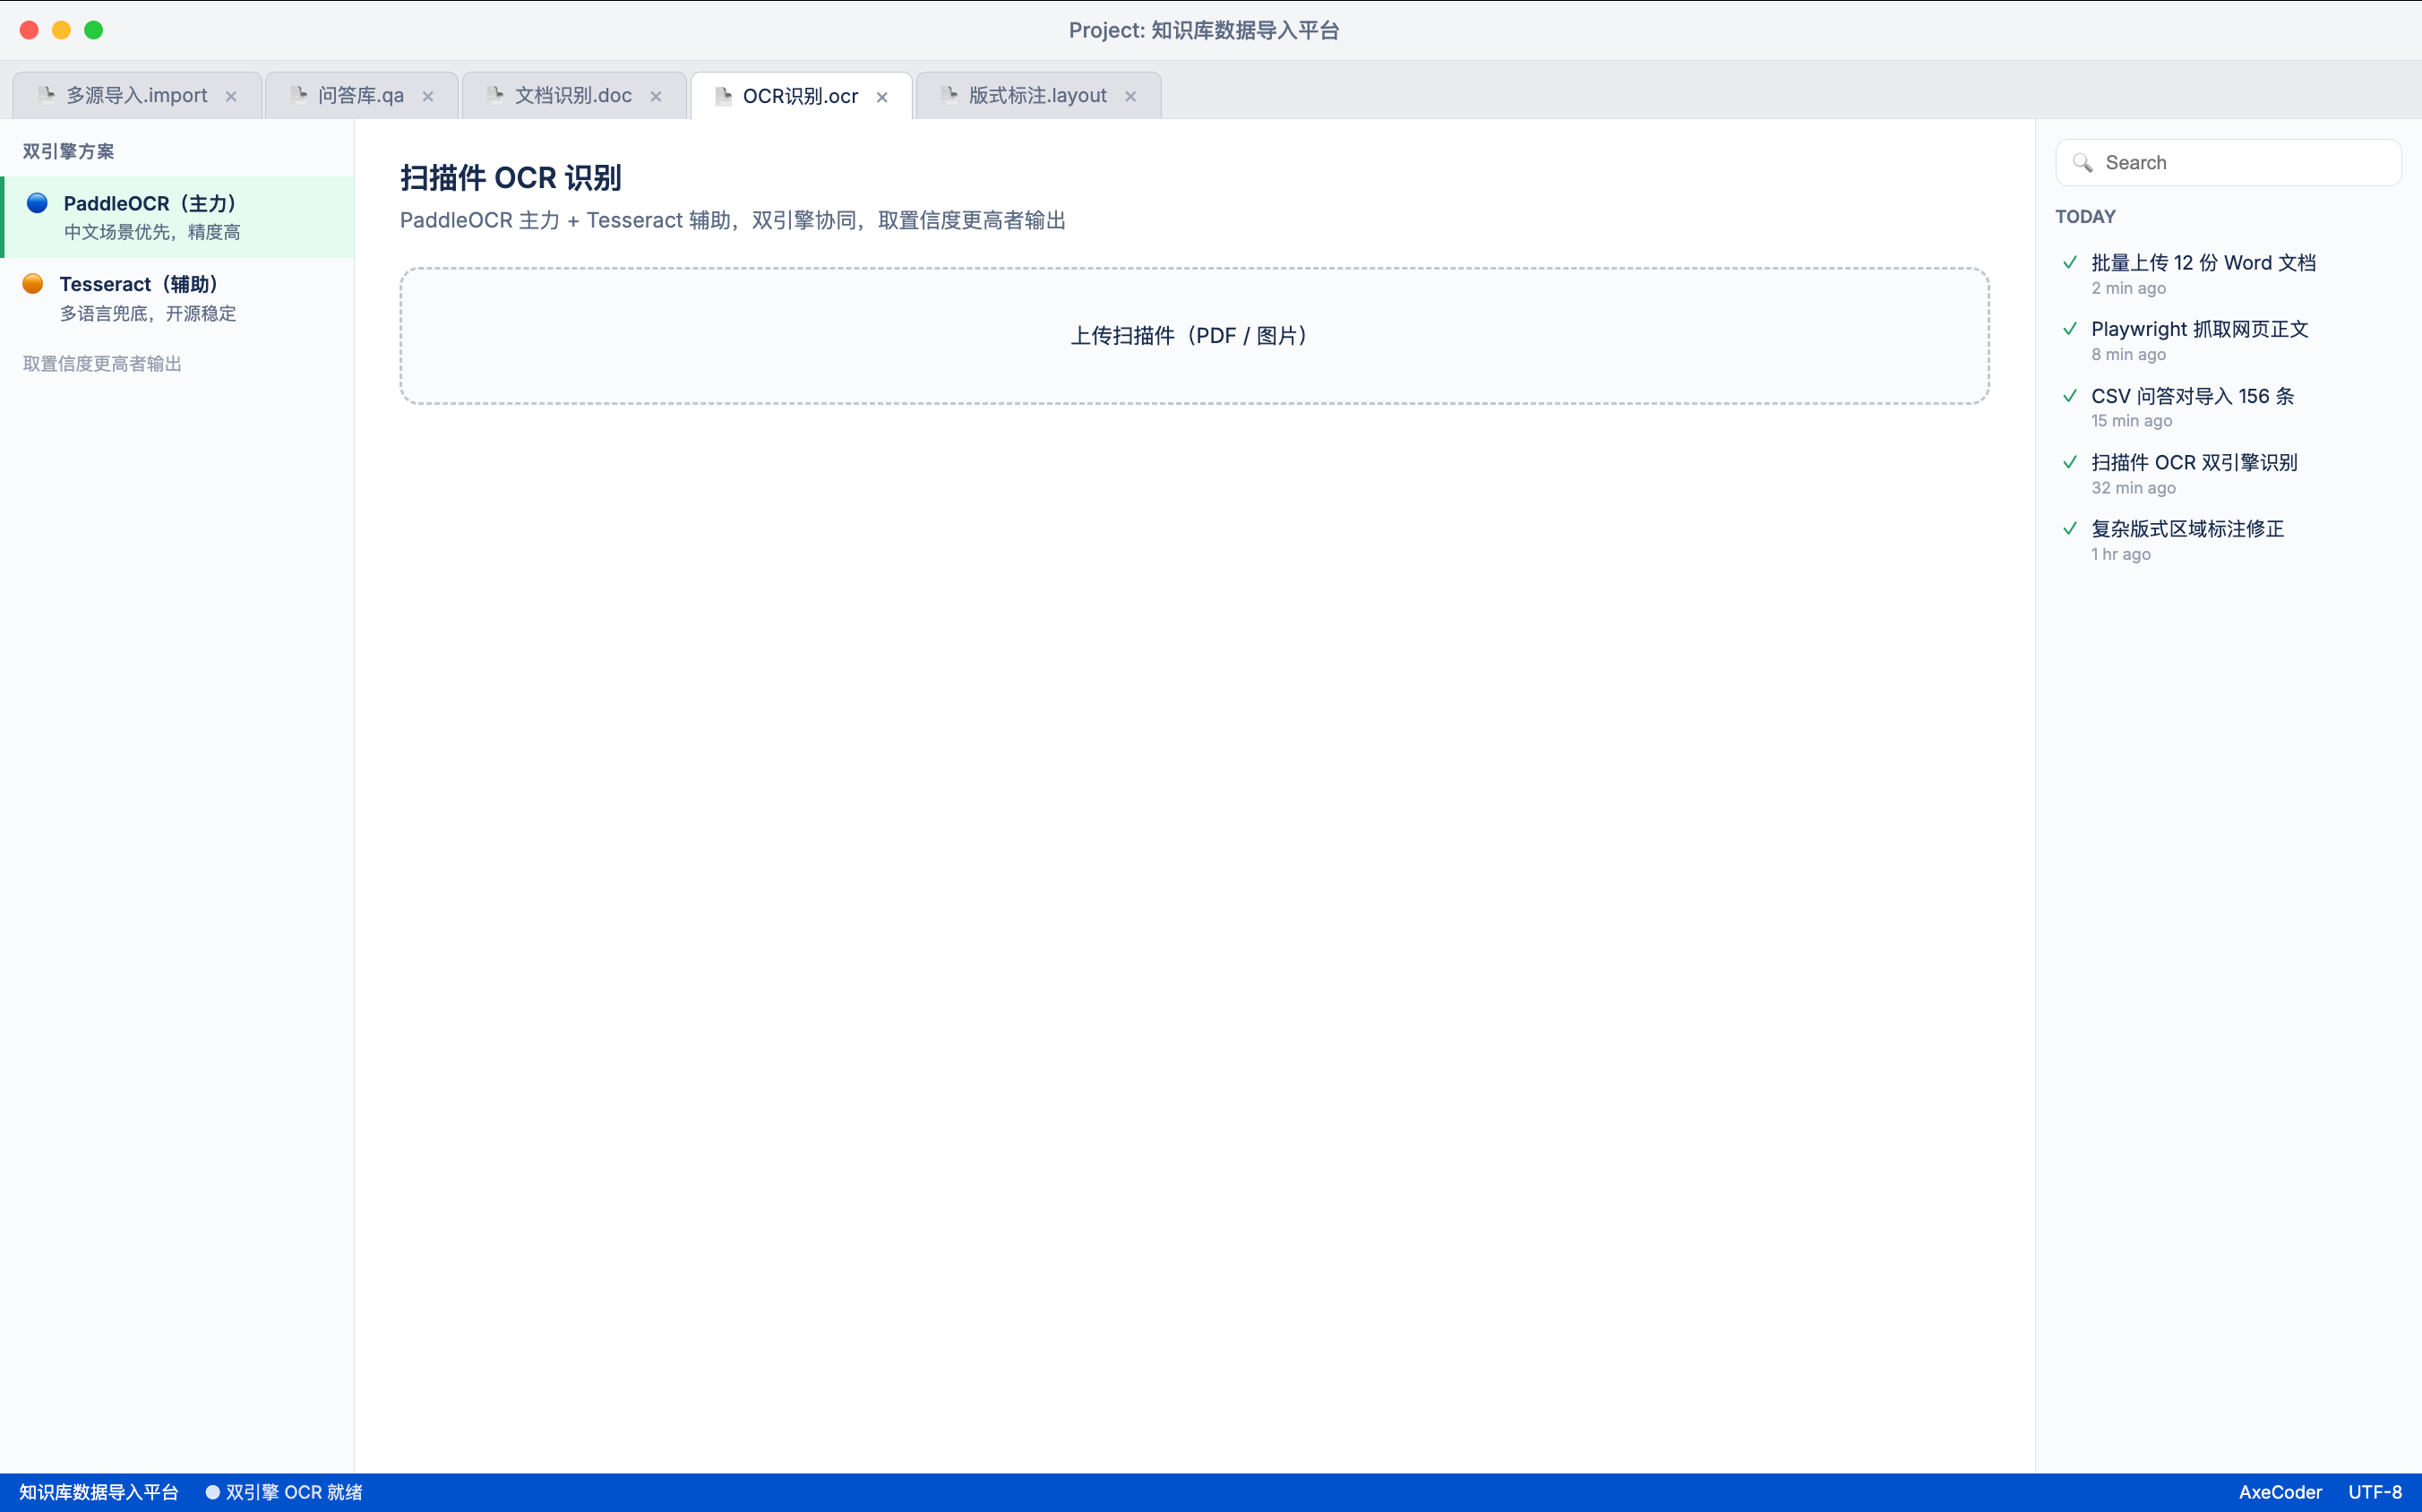
在扫描件 OCR 识别方面,采用 PaddleOCR 主力引擎与 Tesseract 辅助引擎的双引擎协同方案,中文场景优先 PaddleOCR 保障精度,多语言场景由 Tesseract 兜底,两路结果取置信度更高者输出,兼顾准确率与稳定性。
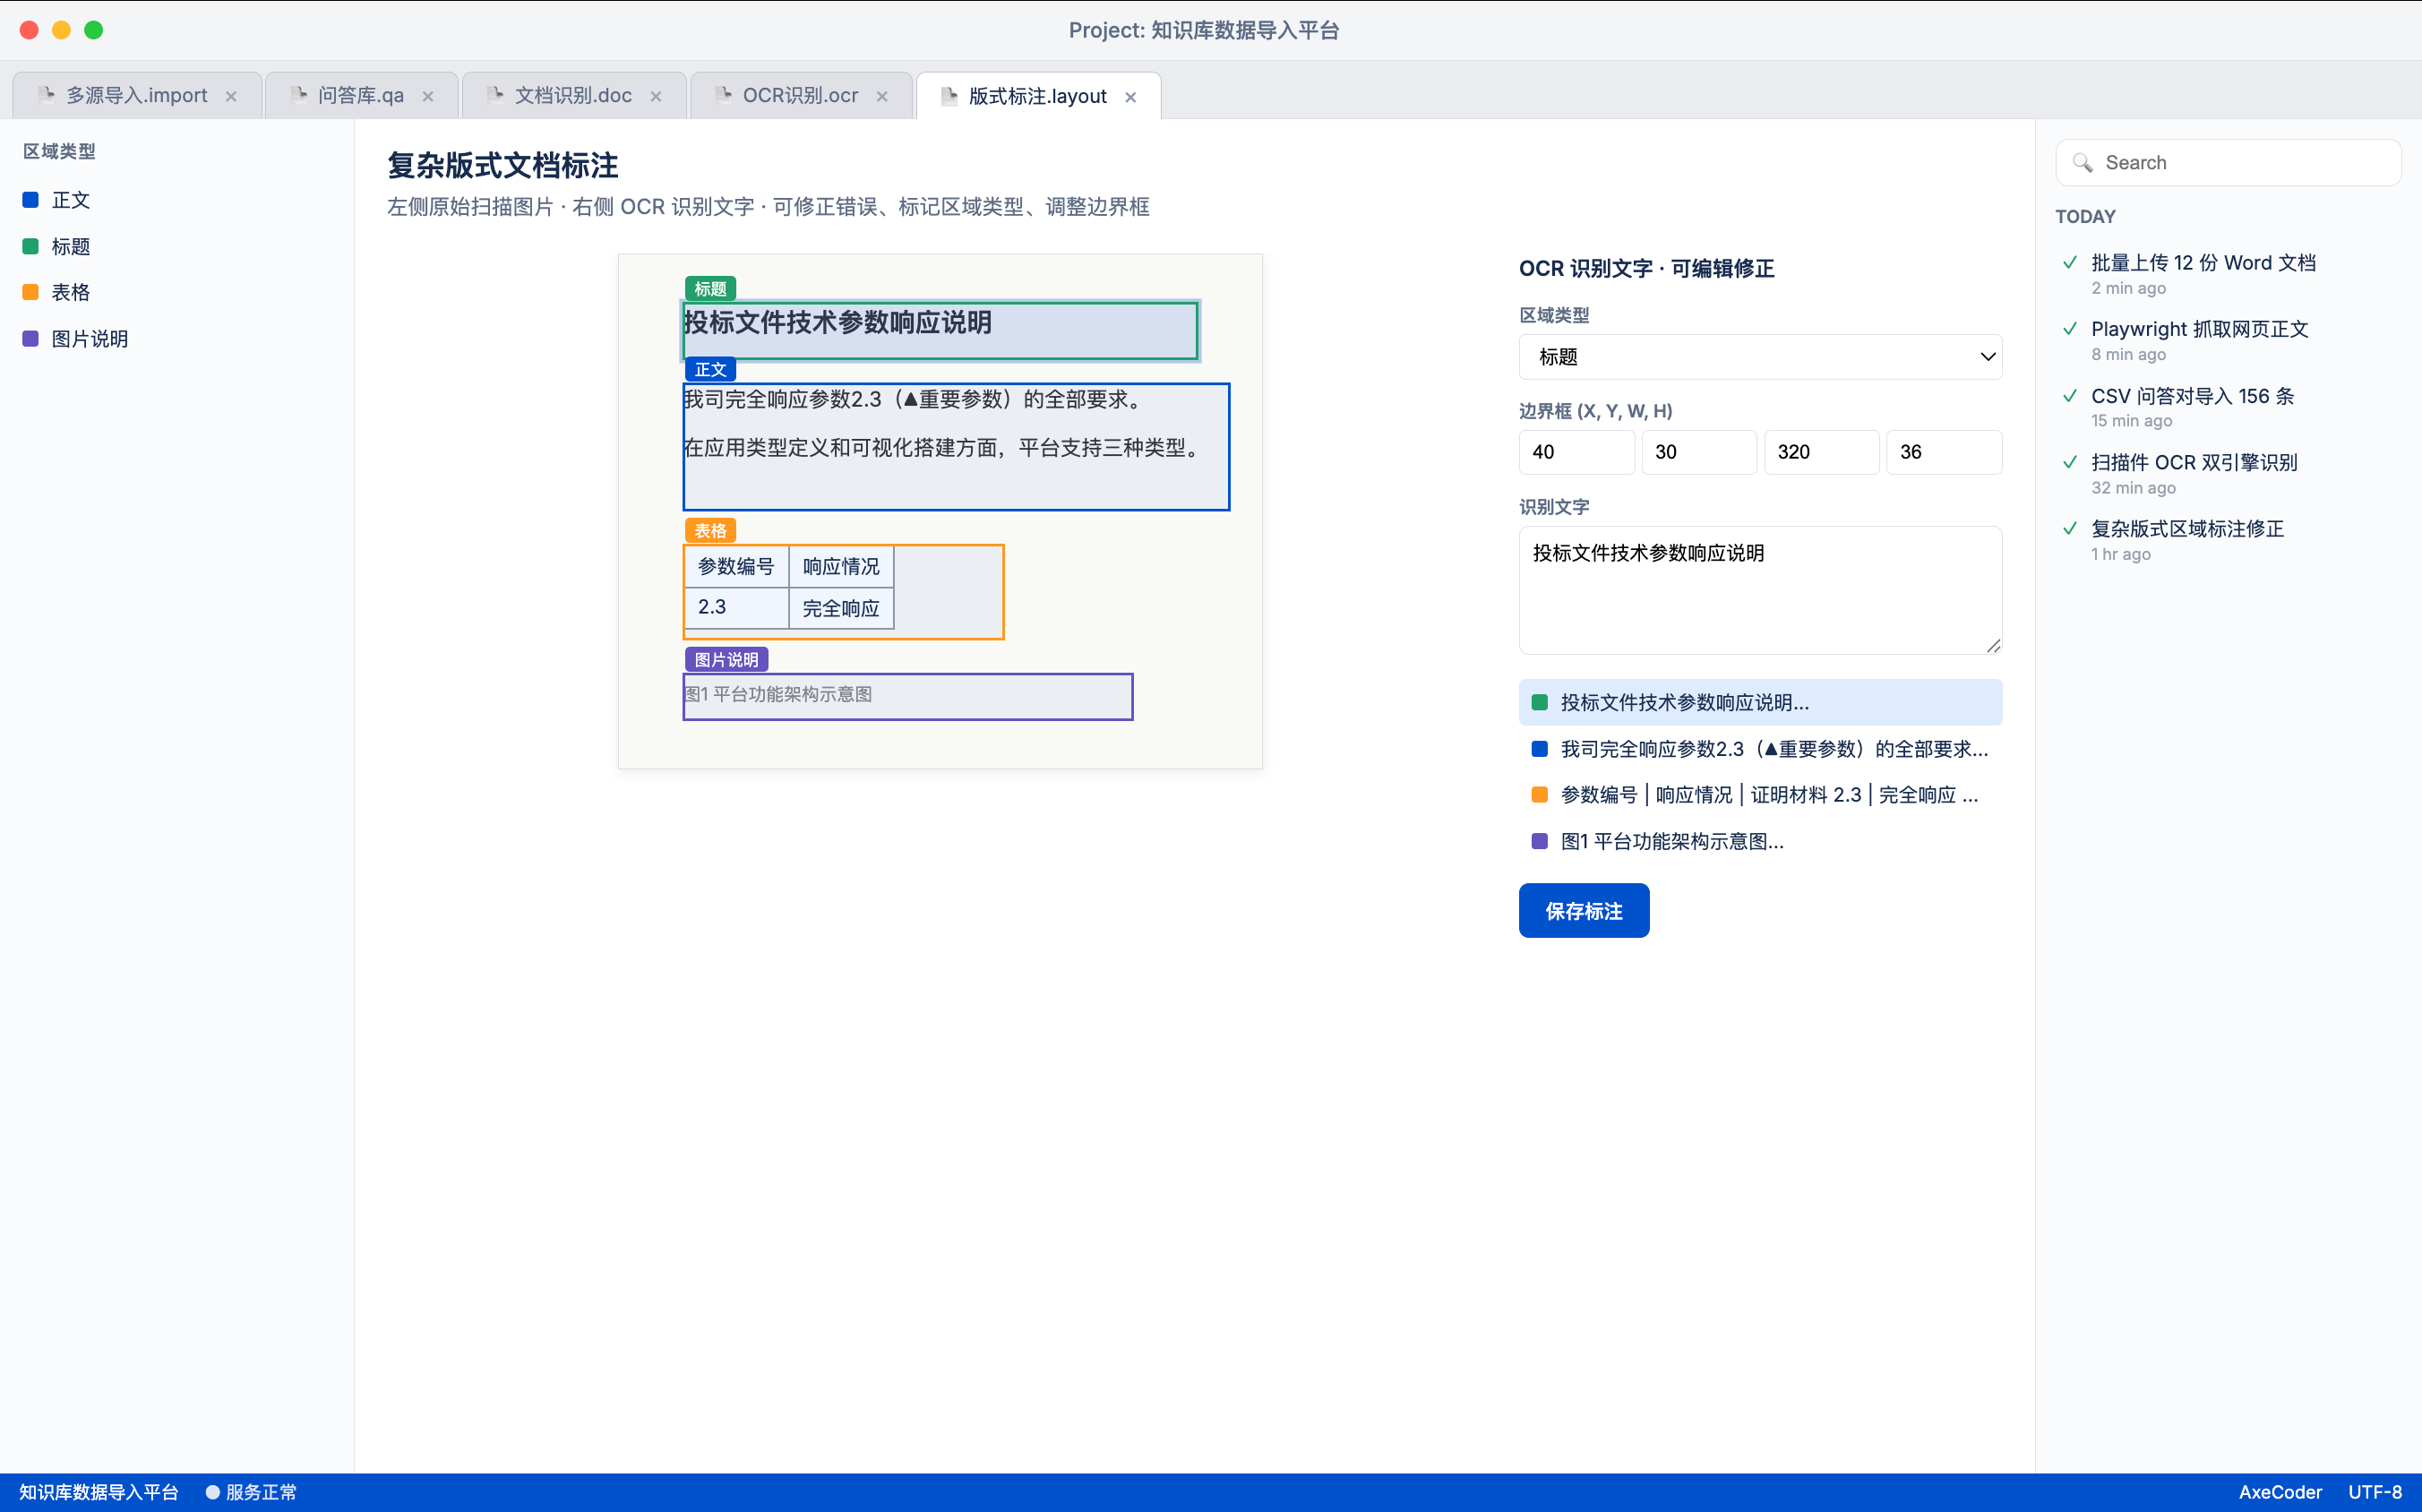
在复杂版式文档方面,配套可编辑标记工具——左侧显示原始扫描图片,右侧显示 OCR 识别文字;用户可修正识别错误、标记区域类型(正文、标题、表格、图片说明等)并调整区域边界框,标注结果保存后与文献元数据关联,支撑后续全文检索与 RAG 问答。